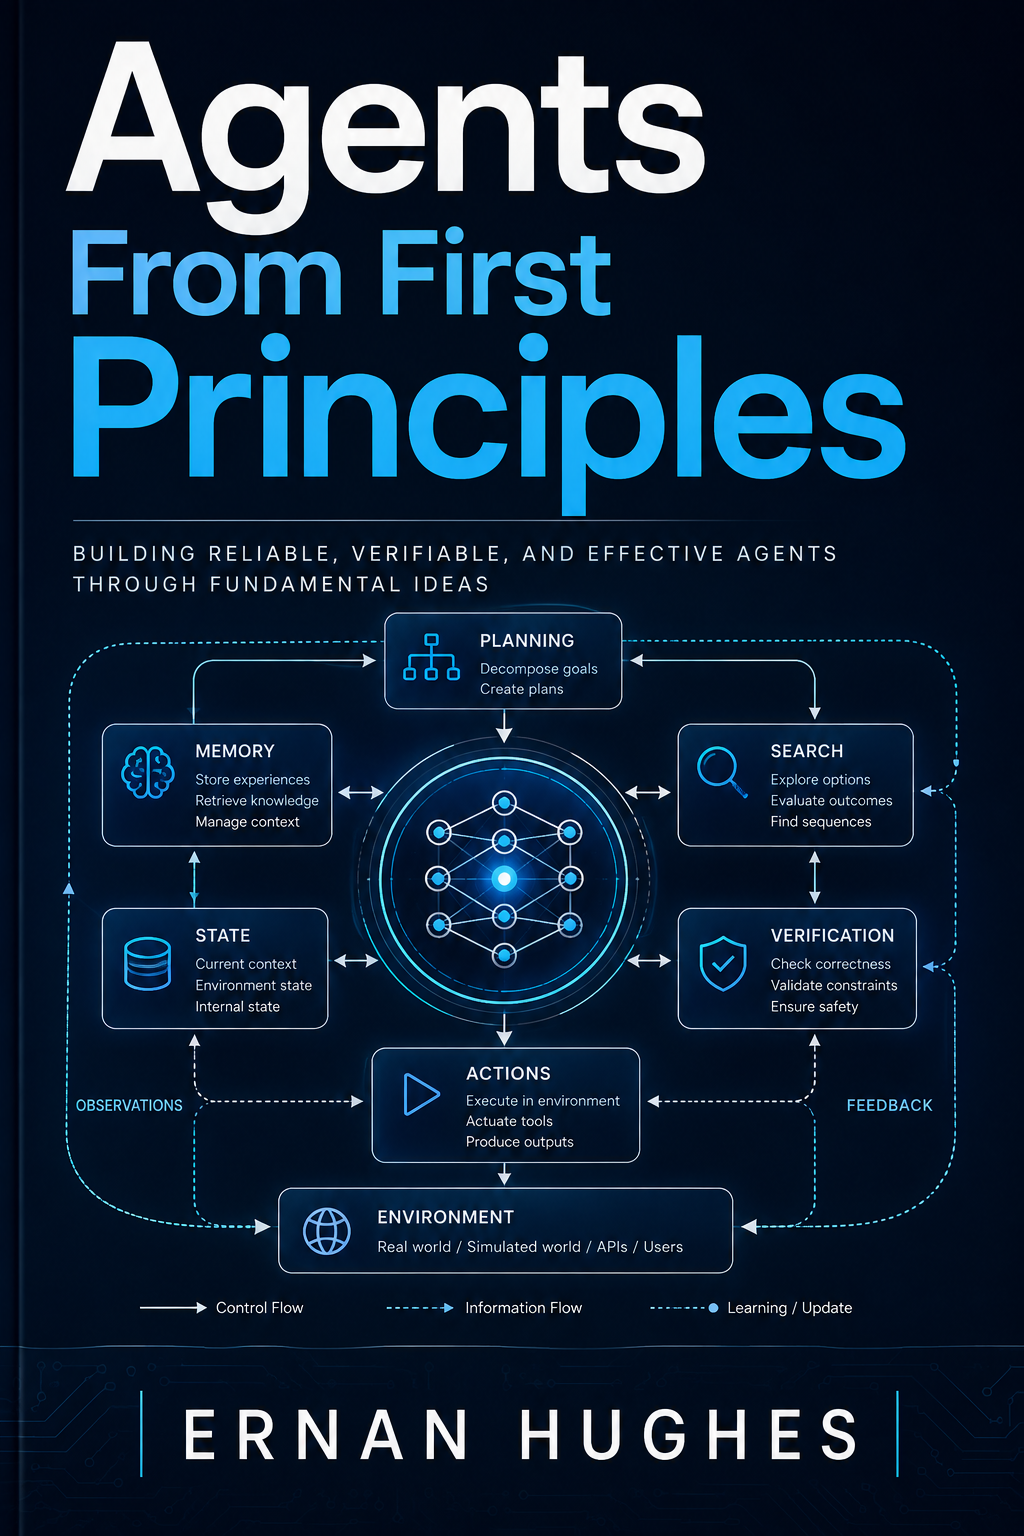
Agents From First Principles
通过理解智能体底层的机制——控制循环、动作、校验、规划、状态、工具、记忆、搜索与外部验证——来构建可靠的 AI 智能体。
智能体不是一句提示词,不是一个叫 Agent 的类,也不是一个框架。
在它最有用的形态里,智能体(agent)是一个正在运行的系统:它能观察自己的环境, 维护一份关于"什么已经确立"的显式表示,决定下一步做什么,通过受控的界面行动, 观察发生了什么变化,然后决定是否继续。
这本书从第一性原理出发搭建这套系统。
我们从最小的有用循环开始,一次只增加一个机制。目标不是记住某个智能体框架,而 是把这套机制理解到足够的深度——框架因此变成你可以检视的东西,而不是你不得不信 任的东西。
贯穿全书反复出现的问题是:
谁来决定接下来发生什么、什么被允许执行、究竟改变了什么,又是什么样的证据 让系统有资格宣称目标已经达成?
我们将要构建的智能体
基本形状很简单:
目标
  ↓
目标契约
  ↓
运行时状态 + 当前观察
  ↓
模型提出
  ↓
动作空间暴露 + 选择
  ↓
校验 + 授权 + 前置条件
  ↓
执行
  ↓
环境观察
  ↓
状态更新 + 进度
  ↓
继续 / 修订 / 重新规划 / 搜索 / 停止
  ↓
证据收集
  ↓
状态绑定 + 完整性
  ↓
验证
  ↓
PASS / FAIL / PARTIAL / UNKNOWN
语言模型可以参与其中某些决定。
但模型只是其中一个组件。
其余部分都是软件。
这个区分是本书的基石。
本书打算教会你什么
通读这些章节,你将学会如何把智能体中隐藏的部分变成显式的。
你将学会如何:
- 通过观察控制流,区分一次模型调用、一个固定工作流和一个智能体;
- 把模型输出表示为提案,而不是受信任的命令;
- 在副作用发生之前,校验结构、语义、权限和工具参数;
- 生成若干种可能的解,把生成质量与选择质量分开;
- 使用批评与修订,同时不预设批评者天然正确;
- 基于证据而不是信心来接受或拒绝修订;
- 把规划与执行分开,让计划成为可检视的程序状态;
- 显式地表示依赖关系、预期输出、重新规划的触发条件和已完成的工作;
- 区分执行轨迹、运行时状态、持久记忆、模型上下文和缓存;
- 度量进度、检测无产出的循环、强制执行预算,并为具名的原因停止;
- 把工具设计成带契约的狭窄能力,而不是模型的模糊扩展;
- 度量工具路由,减少不必要的模型决策;
- 区分工作状态、工作记忆、语义记忆、情景记忆、程序性记忆、检索和缓存;
- 在多条部分轨迹上搜索,而不是一头扎进第一条看起来可行的路径;
- 在明确的算力与成本预算内,分配搜索的广度与深度;
- 在执行开始之前就定义成功;
- 区分"未知"与"假",让缺失的证据永远不会被悄悄地转换成失败或成功;
- 用环境来验证结果,而不是接受智能体自己"我做完了"的声明;以及
- 把这些机制组装成一个完整的智能体,其成功可以被端到端地检视和验证。
目标不是让智能体显得更自主。
而是让它的行为更可理解、更可控、更可度量、更可靠。
一个渐进构建的系统
各章描述的是一个不断生长的计算系统。
01  控制
    是什么让智能体区别于一次模型调用或一个固定工作流?

02  动作
    把语言模型的输出变成结构化、经过校验的提案。

03  候选方案
    生成若干候选,并让选择变得显式。

04  反馈
    诊断缺陷,有意识地修订,并拒绝回归。

05  规划
    把打算做的多步工作与执行分开表示。

06  状态与进度
    追踪什么是真的、有没有任何改善,以及何时停止。

07  工具
    设计动作空间、暴露规则、路由、schema 和能力契约。

08  记忆
    保存有用的过往信息,而不把它与当前状态混淆。

09  搜索
    让多条部分轨迹同时存活,有选择地花费算力。

10  验证
    把证据绑定到状态,并裁定什么才配得上"目标已达成"这个断言。

11  集成
    把这些已经赢得信任的机制组装成一个经过验证的修复智能体。
每一章增加一个新机制,因为前一个系统已经暴露出一个具体的局限。
这个递进顺序很重要。
一旦状态是显式的,记忆就容易理解得多。一旦候选、评分、状态和预算都已存在,搜 索就容易理解得多。一旦动作与预期结果已被显式表示,验证也就强得多。
第 11 章不增加任何新机制。
取而代之,它要问的是:我们构建的一切是否真的能够组合起来:
损坏的仓库
      ↓
复现故障
      ↓
检视当前状态
      ↓
生成候选方案
      ↓
选择与修订
      ↓
规划与搜索
      ↓
授权一次变更
      ↓
执行
      ↓
收集与状态绑定的证据
      ↓
检查完整性
      ↓
裁定目标契约
      ↓
VERIFIED_SUCCESS
第 11 章的重点不是又一层抽象。
而是让积累下来的架构作为一个能工作的系统显形。
核心工程原则
语言模型是概率性的。
这很有用。它能提出动作、候选方案、计划、批评、假设和解读——这些是普通的确定性 代码难以产出的。
但智能体的每个部分并不因此都应该变成概率性的。
当普通软件能可靠地回答一个问题时,就让普通软件来回答它。
这段 JSON 能解析吗?              → parser
这个动作在工具集里吗?            → validator
这条路径被允许吗?                → policy
测试通过了吗?                    → test runner
状态改变了吗?                    → runtime
超出预算了吗?                    → counter / clock
要求的结果发生了吗?              → verifier
这给了我们本书的主要规则之一:
尽可能把正确性从概率性的模型行为中移出,移入可检视的软件。
或者更紧凑地说:
模型负责提出。运行时负责控制执行。环境提供观察。验证器负责裁定这些证据最 终能换来什么。
读完之后你应该能做到什么
目标不是让你认识每一种智能体架构或每一个框架 API。
目标是让陌生的智能体软件变得可读。
你应该能打开一个智能体系统,然后问:
真正的状态在哪里?
什么仅仅是模型上下文?
谁选择下一个动作?
哪些动作实际上可用?
谁来校验它们?
谁拥有这个副作用?
返回来的观察是什么?
进度如何度量?
循环为什么继续?
什么触发重新规划?
什么被记住了,为什么?
系统在哪里可以分叉或搜索?
是什么让它停下来?
什么证据证明目标已达成?
验证路径本身可以被信任吗?
什么信息是权威的,什么仅仅是证据或上下文?
这些问题比任何特定的框架都更持久。
它们也让调试精确得多。
我们不必说:
这个智能体不行。
而是可以问:这次失败发生在生成、选择、规划、路由、执行、状态更新、检索、搜索、 停止、证据收集,还是验证。
这才是构建智能体系统有用得多的方式。
你也会学到什么时候不该构建智能体
智能体并不自动优于一个函数、一次模型调用或一个确定性工作流。
如果路线是预先已知的,工作流可能更容易测试,运行起来也更安全。
如果一次模型调用已经能可靠地解决任务,加上规划、记忆、搜索和多个智能体,可能 只是增加延迟、成本和失败模式。
因此在全书中,我们总是从最简单的基线开始,只有当一个可度量的失败证明其合理 时,才增加机制。
智能体工程不是把自主性最大化。而是只把自适应决策放在它能为其不确定性挣得一席 之地的地方。
这本书写给谁
你应该熟悉基本的 Python,以及"调用语言模型"这个概念。
你不需要有使用智能体框架的经验。
你不需要了解 LangChain、CrewAI、AutoGen 或任何特定的编排库。
示例刻意贴近普通的 Python 数据结构、函数、循环、测试和显式状态,好让机制保持 可见。
框架可以在后面自动化这里的许多想法。
但我们首先想弄清楚:它们自动化的究竟是什么。
本书不打算涵盖什么
这不是一本关于"一切被称为智能体式 AI(agentic AI)的东西"的百科全书。
它不打算涵盖每一种多智能体拓扑、分布式运行时、生产部署系统、安全模型或专门的 研究架构。
那些是重要的主题,但要在核心机制被理解之后才有意义。
本书同样避免把提示词技巧、模拟工具、自我打分,或一组诸如 PlannerAgent 和
CriticAgent 这样命名的角色,当作"可靠的智能体系统已经存在"的充分证据。
名字创造不出机制。
我们会不断追问:这个软件究竟做了什么。
承诺
读完 Agents From First Principles 之后,你应该能面对一个陌生的智能体系统, 弄清楚:
什么是真实的状态、谁选择下一个动作、什么被允许执行、改变了什么、系统为什 么还在继续,以及什么证据证明目标真的达成了。
你还应该能问出最后一个问题:
当系统宣称成功时,它信任的是什么?
一旦你能回答这些问题,智能体就不再是黑箱。它的不确定性并没有消失,但你能看见 那个不确定性从哪里进入、什么在约束它、环境确立了什么,以及最终是什么证据为这 个结果作了担保。
章节
智能体到底是什么?
通过区分模型调用、固定工作流、自适应控制、状态、动作、观察与运行时权限,构建“AI 智能体”的最小可用定义,然后从第一性原理实现一个最小的反馈循环。
动作边界
通过定义有限动作空间、校验结构与语义、将授权与执行分离、把失败视为运行时证据,把概率性的模型输出变成显式、可检视的动作提案。
候选生成与选择
通过生成多个完整候选、用显式标准评估它们、并在替代方案之间做选择,超越单一有效提案——同时不混淆合法性与质量。
批评、修订与接受
通过有针对性的批评与修订改进一个候选,然后比较新旧版本,使运行时能够接受真正的进步、拒绝回归,并避免无尽的自我改写循环。
规划与执行
把打算做的多步工作表示为可检视的计划,在任何东西执行之前校验其结构与语义,并让观察而非习惯来决定剩余路线何时必须改变。
运行时状态、进度与终止
给智能体运行时一份显式记录,记录执行已经确立了什么:观察被归约为结构化状态,进度被度量为状态之间的关系,循环与停滞被机械地检测,终止报告一个具名理由而不是耗尽一个计数器。
能力与路由
把智能体的动作空间当作被设计的软件来对待:能力契约、依赖状态的暴露、显式弃权,以及能说出真正失败发生在哪个阶段的路由指标。
记忆与选择性召回
把记忆定义为来自过去的受控影响,然后围绕合格性、来源、取代、冲突与检索策略构建选择性召回,而不是把存储或长上下文当作记忆。
轨迹搜索
让几个部分成形的未来活得足够久,久到证据能把它们区分开,把扩展、评估、分配、剪枝与终止当作五个独立的策略,施加在有界的测试时计算之上。
证据与验证
把成功的主张与证据分开:定义目标契约,把证据绑定到状态,保护一个最低证据门槛,并把验证器本身当作一个对抗性接口来对待。
构建完整智能体
把十个机制组合成一个可运行的智能体,放到一个真正坏掉的仓库上。新增不加任何机制。报告那些独立构建的章节在名字、状态身份与谁拥有真值这些接缝上哪里起争执。