上下文窗口是预算
把模型窗口当分配问题的外约束,区分 provider 上限、运行时自己的准入政策与成本,不再把容量当填满的目标。
第 3 章收在多来源、一有限终点。本章讲终点。
想象团队在百万 token 窗口的模型上跑编程智能体。故事是编的,不是关于这种事多久发生一次的证据。它们的会话很少超过 150,000 token,没截断,窗口嘛它们推理说,问题解决了。然后长修复会话意外停了。它可能撞上运行时设的低得多的上限。更靠近 provider 上限的请求反而可能给输出留不够位置,一串贵的请求可能超团队的开支预算,两个 token 上限都没碰到。这是不同的失败:违反 provider 容量、没给输出留够容量、撞运行时政策上限、超经济预算。远低于百万 token 的会话说明的是后两种,不一定是前两种。advertised 窗口只描述团队 operat 的系统的一条边界。
本章建这个房间。很多可能的贡献竞争有界容量,工程问题跟着变:不是怎么填满窗口,是什么值得预算的一份。
advertised 上限什么意思
混淆从数字开始。“1M 上下文窗口"听起来像允许给一百万 token 输入。Provider 文档说不是,方言不该 assumed 相同。第一性原理的说法是:每模型都对一次计算能参与多少信息设约束,约束怎么数须读 provider,不能 assumed。
两例子说明形状。OpenAI 的对话状态文档说上限覆盖单请求里的输入、输出、推理 token。它当前旗舰模型列 1.05M token 上下文窗口、128K 最大输出,整窗口给输入的请求就没位置回复了。
Anthropic 的文档画类似的边界,规则不同。请求里的一切都计入窗口:系统提示词、每条消息(含工具结果)、图像文档、工具定义。输出也计入,含 extended thinking。早轮的 thinking 块留不留在后面请求里看模型。当前模型列 1M 窗口、128K 输出,早些模型比如 Sonnet 4.5 是 200K。上溢有规定:单独超窗口的输入拒绝;装得下但给请求的输出留太少的输入,近期模型接受,可能生成中途停并给显式 stop reason。缓存前缀照样占窗口。
DeepSeek 的价格页列 1M 上下文长度、384K 最大输出,缓存命中与没命中输入价格分开。这加了下面要讲的第二点:占同样容量的 token 定价能差很多。
这些是 dated 事实,2026 年 9 月对 provider 文档验证过,会变。在这里为它们展示的结构,不是为厂商比较。窗口数跨模型 provider 不能直接互换,因为分词、输出上限、推理记账、请求语义不同。上面每种方言里 headline 数都比输入 allowance 大,因为输出、推理、加进请求的任何东西都从同一容量出。外墙真实,没人住在墙根。
三种约束
headline 数归位了,本章能陈述模型。三种约束管上下文该准入多少。它们是不同种类的东西,不是三个 token 上限。
硬容量是 provider 与模型设的。可以是一组约束,比如最大上下文、最大输出、模态或请求尺寸上限。本章说明常用一 token 上限。它是 provider 事实,控之外,随模型版本变。
可用预算是运行时自己的政策:在尊重 provider 适用上限、给输出留位置、推理(适用处)、计数不确定性、margin 之后,选择分给准入输入的量。它不是 provider 事实。provider 用共享输入输出窗口处,运行时建模成容量减预留;provider 设独立上限或不同记账规则处,减法只是近似,代替不了 provider-specific 验证。
经济与运营预算约束所选上下文在钱和时间上花多少。它是多维的:美元和毫秒没有显式政策合不成单 token 上限。钱花多少取决于 provider 定价、token 记账、生成的输出、缓存处理;延迟还取决于模型执行、基础设施、请求形状。调用前这些是估计或上限,实际收费与计时只能事后 reconcile。
provider 约束    → 硬容量
运行时政策       → 可用上下文预算
定价、延迟、缓存→ 经济与运营约束
下面是运行时分配容量的有用核算图。它是推理分配的工程模型,不是任何 provider API 语义的描述,是预算分类,不是[第 3 章](/zh-cn/books/context/03-chapter/)那样的上下文来源分类。
硬容量
│
├── 准入输入
│     ├── 常驻        跨调用在场
│     ├── 任务特定     为当前任务准入
│     └── 累积        早轮保留下来
│
└── 预留容量      不是准入上下文
      ├── 输出
      ├── 推理(适用处)
      ├── 运行时不确定性
      └── 安全 margin
类别描述 lifecycle 与核算行为,不描述来源或权威性。逐调用 total 里,每捕获贡献须按显式规则派一类,lifecycle ambiguous 也一样。任务中途编辑的项目文件可能不再稳定,检索文件可能变成 retained 历史,再生摘要可能替换早期材料,工具定义可能注册后才出现。这些事件跨调用改分类,不改来源。[第 3 章](/zh-cn/books/context/03-chapter/)来源到这里的映射因此是近似;raw parts 还在,ambiguous 指派报告出来,分类字节 total 对捕获表示 reconcile,不对 assumed 的 provider token total。
预留容量和上面三类种类不同。它不是另一层上下文。它是 deliberate 不分给准入输入的容量。
每类有自己的动态,分解才挣得位置。常驻项会话里不变,每准入的调用都占容量。任务特定材料随工作来去。不管理的 append-only 轨迹里,累积上下文随交互增长,直到某机制限制或变换它,真实系统截断、压缩、替换、外化。累积上下文是不是真实会话里打破预算的类别,是假设不是测量。
一次 work 的预算:一会话,三轮
核算模型用数字 concrete。考虑修复轨迹,provider 相关共享容量建模成 200,000 token,harness 政策上限 120,000 输入 token。80,000 token 差是输出、推理(相关处)、不确定性、margin 的保守规划 allowance;不是说每调用恰好生成或预留 80,000 token。这个简化模型 assumed 共享容量约束,不代替 provider 的独立输出与请求规则。数字是合成的,和[第 2 章](/zh-cn/books/context/02-chapter/)的捕获表一样。真预算表须把观测字节和估计、声明、provider 报告的 token 数分开标。
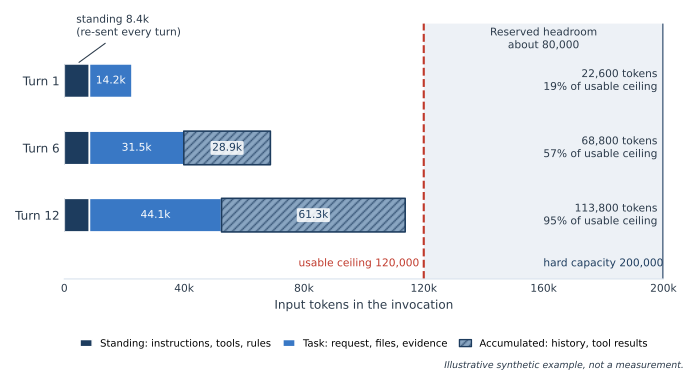
三读数从算术跟出来。第一,常驻块 8,400 token 十二调用全在,每示意轮恰一次调用,累计占 100,800 输入 token 位置。那是关于合成轨迹的假设,不是三快照支撑的结论。它不是账单:缓存改变价格。第二,累积上下文到第十二轮占 113,800 输入 token 里 61,300,大多数,只数新准入材料的政策漏掉 retained 占用。第三,第十二轮用政策上限 120,000 的约 94.8%,硬容量 200,000 的 56.9%。只盯 provider headline 的监控看不到离 harness 自己的上限多近。[第 2 章](/zh-cn/books/context/02-chapter/)的观察器给这些量估计提供捕获材料;它的 provider 前计数绝不当 provider 验证的 token 用量呈现。
例子没说第十二轮行为坏了。行为是[第 5 章](/zh-cn/books/context/05-chapter/)的主题。它只说明核算有形状,只盯 headline 数的团队看不见它。
在 Context Viewer 里检查
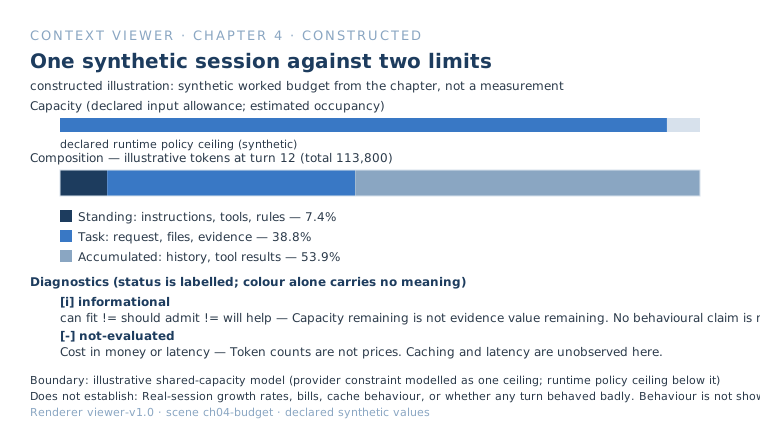
本章的 viewer scene 用同样数字渲染同样合成预算的第十二轮 state:常驻 8,400、任务 44,100、累积 61,300,对 120,000 政策上限,200,000 硬容量作上下文。交互视图里对比第 1、6、12 轮的时间线。看什么:哪类增长,哪个上限先 binding,每个上限留多少 slack。这是构造说明,不是测量;它确立核算形状,不确立行为或钱上的成本。
常驻与边际成本
核算图蕴含实践区分:上下文拥有什么花钱,加什么花钱。描述准入材料随时间怎么参与。它们不是固定的信息类型。
常驻成本是条目准入的每调用都付、留多久付多久。本章及后面,常驻成本指 recurring 容量占用,除非显式点名钱或延迟成本。工具 schema、项目指令文件、稳定系统材料是典型。一 500 token 工具定义单看小,四十调用占 20,000 输入 token 位置。一条目同时有几个成本:源尺寸、每调用占用、轨迹累计暴露、价格、缓存处理。这些是不同的测量,累计占用不等于钱上的成本。
边际成本是准入或替换决定造成的调用占用变化:多读一文件、多一工具结果、多一轮、多一检索文档。它不总等于新条目尺寸。新摘要可能替换更大的历史,净变化为负,工具结果在上限下可能挤掉别的东西。报告边际占用,对比相关的前后表示,说清数是 gross 增加还是净变化。边际成本感觉像真花钱,因为准入是看得见的决定;recurring 占用容易 overlook。
条目在两者之间移动:
新准入 → 现在的边际成本 → 跨轮保留
              → 后面的 recurring 占用
为它服务的任务读一次的 10,000 token 文件,贵但可能值。同一文件三十轮 verbatim 重发,第一轮之后行为像常驻成本。[第 2 章](/zh-cn/books/context/02-chapter/)的仪器帮分开这两者:连续捕获派生的重复与字节稳定性,把 recurring 占用和新材料分开。这连到[第 1 章](/zh-cn/books/context/01-chapter/)的时间维度。缓存感知排布([第 9 章](/zh-cn/books/context/09-chapter/))、工具上下文([第 17 章](/zh-cn/books/context/17-chapter/))、剪枝外化(第 10、13 章)各继承这个词汇。
按来源核算
没人跟踪的预算是愿望。想要的 enforcement 台账把每准入贡献归因到来源,不 double-count 核算容量占用。当前仪器支撑更窄的台账:它记录工具定义、工具结果、消息 role、压缩请求,但在没区分的系统块里分不开厂商、产品、项目作者。项目文件来源可由 operator 声明而不是观测。宿主侧观察器也不能因为捕获了来源的字节,就给每来源派精确 provider token 数。有用的台账 reconcile 能 reconcile 的,估计或声明的 token 分配 label, unattributed 材料保留而不发明 owner。[第 2 章](/zh-cn/books/context/02-chapter/)的观测、派生、声明、joined、没观测状态作用到单个字段,不一定是整行。
归因让归属与补救可讨论,虽然不定死每行一 owner。项目文件属于仓库作者,工具 schema 属于另一团队,历史政策属于 harness。工程模型里,常驻成本超支和累积上下文超支倾向不同补救,比如前者删工具或缩短 preamble,后者剪枝、外化或压缩,“上下文变大了"一概而论倾向开错药方。后面的章节提机制时,每个说清它移动台账哪几行。
系统为什么留着窗口不满
硬容量是外墙,为什么不盖到墙根?因为容量上几个 claimant 提前测不出来,运行时按政策对它们预留:
- **输出。**回答须有地方去。provider 的最大输出是一回事,任务期待要的输出是另一回事。单调用须给它请求的回答留位置;多调用智能体还要后面调用及其工具结果的轨迹政策。后面的调用不自动是当前调用窗口的一部分。
- **推理。**模型先推理后回答的,推理占不占窗口 provider-specific,如上核算所示。
- **运行时加的材料。**观察边界前 harness 加的材料可观测可计数。边界后或 provider 加的材料没观测,预留是 cover 它的办法。Anthropic 的上下文感知功能在有的模型上把剩余容量信息注入请求,请求含功能自己的输出。
- **计数误差。**数是声明、估计或 provider 报告([第 2 章](/zh-cn/books/context/02-chapter/)),一计数下贴上限的包在另一计数下可能上溢。
- **未来轮次。**这是轨迹政策,不是当前请求的 provider 要求。retained 历史占后面的调用,当前请求预算填满逼得后面轮次提前压缩、截断或外化。未来轮次有自己的请求核算;它的 token 不是字面预留在当前调用里。
- **安全 margin。**Provider 在边界拒绝或 halt 的 grace 不一,margin 把悬崖变成坡。大小是政策选择。
“窗口用几成?“没有通用答案。正确的预留取决于任务、期待输出、轨迹长度、模型、推理模式、provider 语义、不确定性。没有通用利用率目标,上限是工程决定不是配置默认。
token 数不是成本
四样东西都叫成本,是不同的测量:token 数、容量占用、钱、延迟。token 数相等的两包价格能不同,缓存前缀和没缓存 token 在有缓存的 provider 计价不同,延迟取决于模型、基础设施、请求形状、缓存,不跟价格走。这些都不改变窗口装什么。都改变用窗口花什么。
缓存 token 不是免费容量。Anthropic 的文档说缓存前缀照样占上下文窗口:缓存改变那些 token 的付费,不改变它们计数。容量和钱走不同的规则,顾一头不管另一头产出熟悉的双胞胎失败:装得下但贵,省到没用的包。缓存的机制归[第 9 章](/zh-cn/books/context/09-chapter/)。这里够的是记在一约束下的决定须到别的约束下检查。
分配问题
本章的主要动作现在能陈述:
工程问题不是怎么填满窗口,是什么值得预算的一份。
候选贡献多了,容量有界,可用预算是政策,准入是分配问题。准入条目耗预算,任何特定 provider 的窗口尺寸如何都不变:
候选信息 → 准入决定
        → 表示 → 耗掉的容量
很想形式化成单位 token 价值:每候选带价值与 token 价格,组装在可用预算里最大化价值。草图是有用的想法、危险的蓝图,因为候选不独立。拿两文件,第二定义第一用的词。一起准入价值超各自价值之和,分开准入第一近乎 worthless。依赖面前 per-item 分数活不下来。第 22 章说明排序为什么解不了,第 23 章建把依赖当一等输入的机器。
本章确立的是分配问题避不开。[第 3 章](/zh-cn/books/context/03-chapter/)分类里的每来源都是候选 claimant,准入 bound 在 provider 约束与运行时政策,claimant 能互动。窗口填到边不是 thorough。每 claimant 拿想要的,指望结果 work。
测什么,不测什么
本章的断言是核算,测试也是核算不是行为。第一检查是分类字节对观察器捕获表示的精确 reconciliation,unknown 类别保留。第二是重复、新准入、替换的贡献跨捕获调用分不分得清,不把字节同一误当 provider 分词同一。第三是轨迹投影(陈述增长估计器与观测区间)报不报可能的政策上限 crossing;它是有条件投影,不是智能体行为的预测。最后,声明或估计的 token total 须在正确匹配的调用上和 joined 的 provider 用量比过才信。provider total 不必拆成观察器的类别。压缩、工具循环、任务变化能让投影失效,单个观测增长率不该提成 general 规则。
加无关材料看帮忙还是捣乱是[第 5 章](/zh-cn/books/context/05-chapter/)的实验不是这个的。这里记录行为是读核算的 covariate,永不是 verdict。本章什么都没跑,它指向的真实会话成分依赖还不存在的语料。
本章的断言小而精确。剩余额度不是价值剩余额度的证据。窗口大把空位不蕴含该多准入,所以:
装得下 ≠ 该准入 ≠ 有帮助
下一章拿最后一个不等式,问上限内准入的更多上下文无害吗。
参考
- Anthropic. “Context windows.” Official documentation, verified September 2026. Window accounting; sizes by model; thinking and tool use counted; overflow behaviour; cached prefixes occupy the window; context awareness on some models. Provider-specific and version-sensitive. https://platform.claude.com/docs/en/build-with-claude/context-windows
- OpenAI. “Models.” Official documentation, verified September 2026. Current flagship models: 1.05M context window, 128K maximum output. Provider-specific and version-sensitive. https://developers.openai.com/api/docs/models
- OpenAI. “Conversation state.” Official documentation, verified September 2026. Token limit includes input, output and reasoning tokens. Provider-specific. https://developers.openai.com/api/docs/guides/conversation-state
- DeepSeek. “Models & Pricing.” Official documentation, verified September 2026. 1M context length, 384K maximum output, cache-hit and cache-miss input pricing. Provider-specific and version-sensitive. https://api-docs.deepseek.com/quick_start/pricing