先复用,再重算
把跨请求前缀复用当上下文排布的经济与结构属性:重复上下文何时不必重复算子,怎么测复用,为什么可缓存性不说明内容该不该在。
这里是个说明场景,不是测得的 case。长调试会话的团队按第 2 章仪器看到的行动。轨迹显示 20,000 token 重复文件读取与过时工具输出,加清理 pass 每次请求前 strip 它们。可见 token 数降六分之一。假设下张发票涨了,延迟没改善。可见数降了,provider 记账对新处理、缓存写入、缓存读取 token 定价能不同,清理早期历史的 edit 改它们里哪个请求含什么。更小的渲染请求不一定是更便宜的请求:
token 最少 ≠ 成本最低
第 8 章收在反事实:没有跨请求复用,重复稳定前缀要求重复处理。本章问 serving 系统实际复用什么、复用怎么测、改上下文怎么改变它的价值。这是关于经济与排布的章节,不是容量。
两缓存,分开
第 8 章把模型推理 state 和跨请求前缀复用分开。模型推理 state 是模型与 serving 结构在一代的 decode 步骤里用的东西。跨请求复用是 serving 层机制:新请求在 provider 规则下和以前的处理兼容,部分 work 不重复。
Provider 命名实现各异。OpenAI 文档说缓存 state 住单机,请求须到对的机器。SGLang 的 RadixAttention(开放 serving 系统)把提示词组织成 radix 树,共享前缀的请求复用 KV 缓存算子。它说明原则不是 proprietary,不 license 对任何商业 provider 内部的推断。本章 general 想法叫"跨请求复用",各 provider 自己的功能用它自己的词。
重复上下文不必重复算子
智能体会话是重复的研究。一百轮可能同样指令、工具定义、项目规则、早期历史开头,只在最新观察分歧:
请求 1    处理 A B C D
请求 2    处理 A B C D E
请求 3    处理 A B C D E F
有复用,共享 work 做一次:
请求 1    算子 A B C D
请求 2    复用 A B C D,算子 E
请求 3    复用 A B C D E,算子 F
重复上下文 ≠ 重复算子
但只在条件下成立,三层须分开:
结构可复用   两渲染请求共享前导区
        ↓
provider 准入   provider 规则让其中一些准入
        ↓
实现复用       telemetry 显示真复用了
共享前缀不是缓存准入前缀,两者都不是缓存命中:
共享前缀 ≠ 缓存准入前缀 ≠ 缓存命中
准入和命中之间隔着可用与路由:兼容条目须建过、还可用、请求在 serving 系统规则下够得着。provider 用量 telemetry 报告实现的缓存读或命中,但不必揭示准入前缀为什么 miss、哪段 span 复用了。观察器因此把 provider 报告的复用和自己边界测的结构前缀分开记,“可复用"只说结构层。
前缀几何
拿 R1 = A B C D E、R2 = A B C D F。公共前导区 A B C D。第一分歧 E 对 F,结构复用停,因为匹配区 certify 不了后面的东西。这就是本书的抽象,前缀几何:
公共前导区  → 候选复用
第一分歧    → 要新处理
它不是 provider 的算法。实现按块粒度、最小可缓存长度、断点、回看窗口、路由、lifetime、复用自动还是显式不同。几何描述什么能复用,provider 规则与 telemetry 描述复用了什么。
稳定不是位置
几何让第二轴可见。第 6 章结论渲染顺序能行为相关,排布须显式。第 9 章加不同的轴:跨调用的稳定性,条目一请求到下请求变不变。位置和稳定性独立:
位置 ≠ 稳定性
条目能靠前易变、靠前稳定、靠后易变、靠后稳定。坐哪和多久变一次是独立事实。
缓存导向的候选排布跟出来。语义政策约束允许多等价排布处,稳定材料放易变材料前能放大结构可复用前缀:
稳定       指令、工具定义、共享引用
半稳定     历史、早期工具结果
动态       当前 state、最新观察、当前请求
三家 provider 的文档 guidance 共享稳定前缀的偏好,control 不同。OpenAI 建议稳定开发者指令与共享引用材料放前,消息追加不反复改写。Anthropic 文档写缓存断点与覆盖工具系统消息的失效层级;断点须盖住打算共享的请求里相同的前缀。Kimi 同样建议稳定提示词、工具定义、引用材料放逐轮内容前。这里引的 DeepSeek 缓存页没 comparable 的排布 prescription。这些是 provider-specific 指令,不是同样断点策略 lifetime 到处适用的证据,都没确立重排后的行为等价。
缓存优化是约束优化。它在语义、权威性、范围、新鲜度、行为要求已允许的排布里选,违反其中之一就 invalid:
系统要求下 valid 的排布
  ∩ 权威性范围要求
  ∩ 新鲜度要求
  ∩ 行为约束
        ↓
剩下的排布自由
        ↓
缓存优化
那是设计原则,不是实验确立的 law,不给要求排优先级。靠命中 gain 违反管束上下文政策的排布语义 invalid,再便宜也一样。缓存最优顺序和行为最优顺序不必重合,第 6 章说过,排布须说清优化哪个。
追加与改写
历史靠加法或修订增长,复用给两者不同定价。append-only 增长保和 earlier 前缀算子的结构兼容:
第 1 轮    A B
第 2 轮    A B C
第 3 轮    A B C D
每轮延长上轮,结构可复用区能长。earlier 算子还在否看 lifetime、路由、块边界、配置,结构兼容不是实现复用。改写反过来:
第 3 轮    A SUMMARY(B C)
第 4 轮    A SUMMARY2(B C D) E
改写的请求能更短,但改写不一定让后面每轮的第一分歧提前。例子里 SUMMARY(B C) 变成 SUMMARY2(B C D),请求在摘要处分歧,那点之后的材料不再是公共前导区的一部分。后面请求字节相同的摘要本身能成可复用前缀的一部分。剪枝压缩衰减继承的 trade 有条件:更少的准入上下文以丢已有的复用为代价。token total alone 确立不了缓存 effect 或价格。
在 Context Viewer 里检查
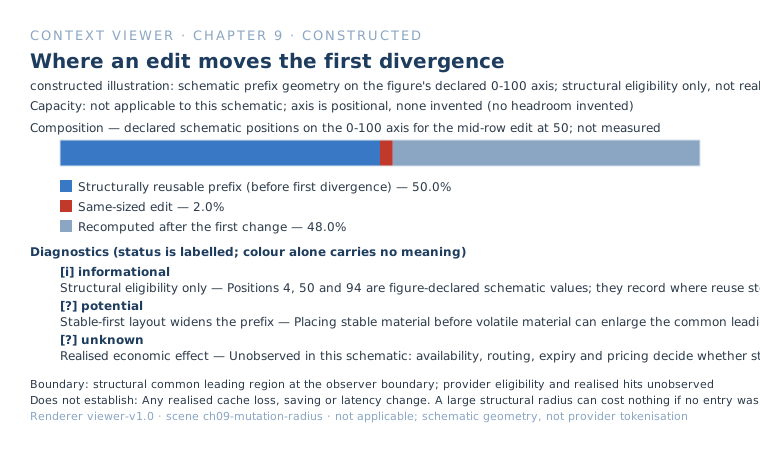
本章的 viewer scene 画本章自己的前缀几何:0–100 轴上声明位置 4、50、94 的同样尺寸 edit,各带结构可复用前缀与重算尾。打开 scene 按位置比 footprint。看什么:第一分歧落在哪,多少结构可复用。几何只说候选——可用、路由、过期、定价决定结构损失变不变成实现代价,这里都没观测。
变更半径
前面小 edit 改可复用区的一大片,概念值得命名,因为改的 token 数 miss 它。结构变更半径是 mutation 引入的第一分歧之后,原来公共前导区(对指定参照请求)落下的部分。它须相对参照请求定义:记录参照前缀长、mutation 后前缀长、第一分歧偏移、陈述本地渲染计数法下的差。[第 2 章](/zh-cn/books/context/02-chapter/)的观察器测量宿主边界表示,不是 provider 的终分词或缓存块边界。所以结构半径是核算诊断,不是 provider 准入或实现缓存损失的直接测量;不 assumed 通用标量。
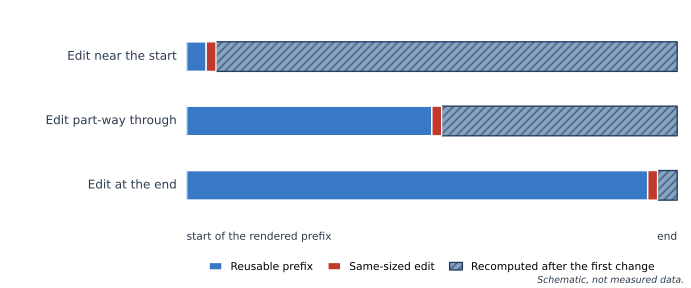
不对称是小 edit 不一定小 footprint:
edit 小 ≠ 结构 footprint 小
文档展示 effect 的变体。OpenAI 列改前缀的办法有压缩、消息延长,Anthropic 给逐请求块上打断点的时间戳陷阱(每请求写条目从不读),Kimi 说前缀任何部分变,它之后的内容不能复用。
结构半径不是实现损失:
变更半径 ≠ 实现缓存损失
大结构半径能零实现代价,比如 edit 前根本没可用的匹配缓存条目。反过来 provider 报告的缓存读能为 mutation 之外的原因变,含路由、过期、请求时机。下面的实验因此拿结构测量和用量 telemetry、派生费用、延迟对比,不把每个 miss 归因到排布。后面的剪枝改写研究捕获允许时记录第一分歧和 token 省数,但只有受控证据说明它预测有用的实现结果,才把变更半径提成运营优化指标。
核算、计费与延迟
可复用前缀创建不免费。经济对比区分建立准入或缓存 state 的首次请求、报告缓存读的后面请求、没缓存剩下的处理。这些是核算类别,不是说 provider 字面做三次分开的算子或统一计费。缓存条目的生产成本、它还在的概率、后面准入请求数决定复用值不值。
请求核算
  首次用: 输入处理了,可能缓存 state 写了
  后面用: 报告复用的缓存前缀 token
           + 处理没缓存输入 token

报告的复用不是新重算的输入
那不是 provider 的计费模型。写是不是单独收费 provider 不一,不同 token 类别定价能不同,所以算子核算 ≠ provider 计费,计费不是延迟。
一常见结构下算术简单。写乘数 w、读乘数 r,相对普通输入,N 次用。缓存花 w + (N−1)r 对 N 次没缓存 N 次,所以 N > (w − r)/(1 − r) 时便宜。OpenAI 当前模型(写 1.25×、读 0.1×,2026 年 9 月文档)约 1.28,第二次用就过简单输入价格 break-even。Anthropic 五分钟写(1.25×)默认读乘数(0.1×)同样;一小时写(2×)要第三次用。这里忽略后缀成本、部分命中、过期、最小长度、路由 miss、延迟,不说行为。
provider 实现不同,是 dated 例子不是 law:
| Provider | 复用模式 | 准入与匹配 | Lifetime | Telemetry | 定价(2026 年 9 月查) |
|---|---|---|---|---|---|
| OpenAI,GPT-5.6 及以后 | 隐式或显式断点,每请求 up to 四写 | 1,024 可见输入 token 最小 | 30 分钟,复用刷新 | cached_tokens、cache_write_tokens |
写 1.25×、读 0.1× |
| OpenAI,早模型 | 隐式 | 请求设置不定 | 大约 5–10 分钟 idle,up to 一小时 | 缓存 token | 写不另收费;读费率看模型 |
| Anthropic | 自动或显式断点,up to 四 | 按模型 512–4,096 token 最小;20 位置回看;只在断点写 | 5 分钟或 1 小时,从请求开始计,复用免费刷新 | 创建、读、断点后 token | 写 1.25×(5 分钟)或 2×(1 小时);读 0.1×,有的模型更低 |
| DeepSeek | 自动,磁盘 | 缓存前缀单元全匹配 | 几小时到几天清;best effort | 命中 miss token | 命中 miss 输入分开价格;查的页面写不另收费 |
| Kimi | 自动 | 块粒度;部分块算 miss | 5 分钟或 1 小时,首次写锁定 | 缓存与写 token | 一模型缓存输入是没缓存一成 |
这些行不能直接比,不提议跨 provider 综合分。lifetime 重要因为 miss 本身说明不了排布:相同前缀跨过期、路由变化、配置变化都能 miss。
最小长度下限
有的 provider 短前缀不缓存,所以下限下完全稳定的前缀零复用。早稿说前缀要"一百多 token"才值得扩展,从下限 alone 推不出,这里是推导。假设没缓存的稳定提示词 L₀ token 在下限 F 下,加材料到 F,缓存准入了。忽略后缀,N 请求缓存赢的条件 F(w + (N−1)r) < N·L₀,即 L₀ > F(w + (N−1)r)/N。F = 1,024、w = 1.25、r = 0.1,N = 10 时 L₀ 须超约 220 token,N = 100 时约 114,N 无限大时约 102。所以一百 token 上下是多复用极限。只算计费,把加的 token 当只花读费率,不管它们的容量与干扰成本。
这不是 padding 的推荐。为缓存加内容 justification 不了:
缓存准入 ≠ 准入 justification
有用的稳定材料本来就该在包里,缓存改变它的经济。它不让本来不必要的材料准入,padding 带来[第 5 章](/zh-cn/books/context/05-chapter/)要求测的臃肿干扰风险。
断点与复用决定
provider 暴露显式断点处,选断点表达运行时期待:前面区复用够多,值回 provider 规则下的缓存。断点排布是让哪些算子可复用的政策,不决定哪些内容属于上下文:
内容准入 ≠ 复用准入
实践里的稳定材料
跨很多请求复用的稳定工具定义在 provider 匹配、最小长度、lifetime 规则让它准入时是强缓存候选,早改一 schema 缩短后面一切的可复用前缀。OpenAI 建议定义与顺序一致,工具搜索延迟加载,发现的工具后追加。那是 provider 优化,不是 general law,工具设计归[第 17 章](/zh-cn/books/context/17-chapter/)。工具定义在窗口有 standing 占用,缓存改变它的价格延迟,不改变它占不占容量。
项目指令文件同样很多请求稳定,直到当前时间、会话标识、live 分支状态嵌进早期块。动态值往后渲染改善前缀稳定性,但行为等价须保留或测试,移动值改变位置相邻。
保留政策和可缓存性是独立轴:
保留义务 ≠ 可缓存性
每轮变的 PIN 管束条目(比如 live 部署锁)复用差,稳定的引用文件 eminent 可缓存。预测可缓存性(排布与 provider 假设下的期待复用)和实现可缓存性(观测到的)不同,本章不加新 label。观察器的 provider 报告用量是 provider 对处理的说法,事后 joined。它不把缓存读归因到单个 span,逐 span 读比直接观测不到,想要须派生或受控请求测量。
可缓存性不是相关性
span 的命中率不说明它该不该在。缓存的无关还是无关,没缓存的必需不是浪费因为它 miss。
可缓存性 ≠ 上下文价值
缓存没确立相关性、新鲜度、权威性、干扰 absence、臃肿 absence。它减少重算、延迟、输入处理成本(复用实现处)。Anthropic 的文档说缓存前缀照样占上下文窗口:缓存改变付费,不改变 token 计数。OpenAI 的页面没说。所以本章最干净的一句:
缓存让差的上下文更便宜。
缓存和选择互补。选择决定什么值得在场,复用决定重复在场的代价。内容政策问什么值得在场,保留政策问什么表示须留存,排布政策问哪出现,复用政策问以前的哪些算子值得保留。它们互动,不等价。
提议的实验
这里什么都没跑。companion 设计可选,只在生态语料确立跨请求复用的 plausible 机会,或单独记录的 pilot 确立,才跑。捕获的字节相同前缀 alone 证明不了 provider 让它们准入、条目还在、测经济 effect 的东西存在。
**测什么。**等价 mutation 的位置在一 provider 缓存下改变实现复用、成本、延迟否。结构半径不同从渲染请求确定性跟出,不用推理调用。经验断言是实现后果。
**分析单位。**一 provider 一模型一缓存配置下冻结的请求序列 fixture。fixture、条件、重复、provider、计时区间分开报告,一缓存 lifecycle 里重复请求不是独立观测。
**两家族,不是一对比。**mutation 位置家族里同样长度 inert 字段在靠前或靠后位置改。渲染总长度、字段尺寸、改的 token 数、实质任务、周围内容尽量按 provider 渲染允许固定;确认实际渲染请求,不信源模板。mutation 后后缀长度早晚条件匹配不了,因为正是位置 manipulation 改的东西。记录后缀长与第一分歧位置当 manipulation 的结果。改写家族里老段换机械建的固定长度 stand-in;干预改的不只 mutation 位置,单独分析。
**条件。**热稳定 control 确立当时可用的实现复用。再早 mutation、晚 mutation、append-only 增长、改写、阻止复用的冷或 churn control。每条件须有别的条件没有的东西。
**计时。**mutation 位置和过期是独立因子。文档的热身序列 prime 相关缓存 state;早晚 mutation 条件跨独立缓存 lifecycle 随机或平衡顺序,时间相近放稳定 control。热身后马上发请求限制但消不掉过期路由 confound。指定间隔重复稳定 control 描述可用 decay,记录实际流逝时间,不拿名义 provider lifetime 当条目还在的证明。
**度量,分开记。**结构:捕获表示尺寸、来源 label 的估计或 provider 报告 token 数、第一分歧偏移、mutation 前后公共前缀长。provider telemetry:选的 API 真报告处的缓存创建、读、miss 或没缓存 token,加 raw 用量记录。经济:记录 provider 模型定价模式货币生效日期的派生费用,估计和实际发票分开,单独报告的写费用算上。计时:instrument 处首 token 时间,测了就 total 延迟。没有的字段是没观测,不是零;报告缓存读 token 的变化是报告复用的证据,不是内部算子或病因的直接观测。provider 分开分析,不合成综合分。
**结果。**早 mutation 比等价晚 mutation provider 报告复用少,附近稳定 control 命中:mutation 位置在这个测试配置下当运营杠杆成立,记录的不确定度下。结构半径不同、实现复用不动:预测的几何差没产出观测的运营差。两 mutation 都不动复用:这些条件下 mutation 位置 benefit 没 demonstrate,不是永不重要的证明。稳定 control 经常 miss:缓存可用、路由、实验 setup 阻止干净归因。复用变价格不动:这里经济 case 没确立。派生费用变延迟不动:延迟改善不断言。telemetry 或重复不够:报告 unresolved,不做阴性发现。effect 量、重复 lifecycle variability、比较规则先报,再说有用差别。
等价早晚 mutation 在实现复用、provider 报告没缓存处理、派生费用、延迟上没测得差别,本书不能拿 mutation 位置当这个测试配置的优化杠杆。结构几何两种结局都活。
删除须交代什么
回到开篇场景,数是编的:上下文 120,000 token,缓存 80,000,其中 20,000 重复读取与过时输出。缓存降了它们的处理成本,没改成员。删除改的不只占用。决定台账(不是方程)列删除影响什么:
| 维度 | 删除的 effect |
|---|---|
| 容量 | 占用降 |
| 处理与经济 | 重复处理降;实现复用可能丢 |
| 行为 | 干扰可能降;任务性能可能变 |
| 信息 | 损失风险涨 |
| 结构 | 第一分歧可能提前 |
项不等价,没定义效用模型不加总。删除成功一定改变捕获表示的成员,但不保证实现处理成本更低:前缀失效在一些定价复用条件下盖过省的。行为与信息 effect 分开评估,删除在受影响区从没准入或条目过期时能零缓存后果。下一章带着这个警告开始删除:
哪些上下文删了不丢必需信息,不毁掉价值超删除好处的复用?
参考
- OpenAI. “Prompt caching.” Official documentation, verified September 2026. Behaviour differs by model generation: write and read multipliers, lifetimes, explicit and implicit breakpoints, minimum length, routing, layout guidance, prefix-change gotchas. Provider-specific and version-sensitive. https://developers.openai.com/api/docs/guides/prompt-caching
- Anthropic. “Prompt caching.” Official documentation, verified September 2026. Automatic and explicit breakpoints, write and read multipliers with model exceptions, lifetime from request start with free refresh, 20-position lookback, minimum lengths, invalidation hierarchy, timestamp trap. Provider-specific and version-sensitive. https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Anthropic. “Context windows.” Official documentation, verified September 2026. Cached prefixes still occupy the context window. https://platform.claude.com/docs/en/build-with-claude/context-windows
- DeepSeek. “Context Caching” and “Models & Pricing.” Official documentation, verified September 2026. Automatic on-disk caching, full-match rule, hit and miss telemetry, best-effort lifetime; separate hit and miss input prices. https://api-docs.deepseek.com/guides/kv_cache
- Moonshot AI. “Use the Context Caching Feature of Kimi API.” Official documentation, verified September 2026. Automatic caching, five-minute or one-hour lifetimes locked at first write, block granularity, stable-first layout advice. https://platform.kimi.ai/docs/guide/use-context-caching-feature-of-kimi-api
- Zheng, L., Yin, L., Xie, Z., et al. “SGLang: Efficient Execution of Structured Language Model Programs.” Preprint, arXiv:2312.07104. RadixAttention for KV-cache reuse in an open serving system. https://arxiv.org/abs/2312.07104