上下文帮忙了吗?
给定供给上下文的受控变化,什么证据把行为差归因给它,什么证据说那个差别有用?六个构造任务、一 reader,bound 它们的阴性结果。
前面章节给编译包确立有界结构证据(第 23、24 章),第 25 章给 specific 历史配置的仪器宿主边界交付证据。两者都没确立交付的包改变 reader 的决定或改善任务结果。本章问:
给定供给上下文的受控变化,什么证据充分把行为差归因给那个上下文,什么证据充分说那个差别有用?
证据小,弱点是发现的一部分,不是藏起来的 qualification。主要研究用六个构造任务、一 reader(immutable 模型 identity 没捕获)。校准 control 没测到意图行为,探索 reader 迁移探针同时换 reader 和大半包条件,候选删除序列从已在打分 floor 的结果出发。这些 limit 约束因果归因,不只 general。
什么 kind 证据
| 种类 | 问题 |
|---|---|
| 结构 | artefact 满足声明的构造约束吗? |
| 传输 | 认出的 treatment 在声称的运行时边界观测到吗? |
| 行为 | 上下文受控干预下回答或结果变了吗? |
| 生态 | 这些情形 effect 真实工作多久发生? |
这些是不同的断言,不是一分数的 levels。真实会话语料是空的,这里没有生态的。
六任务梯子没用[第 25 章](/zh-cn/books/context/25-chapter/)的 live OpenCode 路。harness 把冻结包文本直接插进 reader 提示词的项目上下文节;无上下文条件用同样 wrapper 加标空节。所以 treatment 是那个 harness 里组装的输入文本,不是单独 reconcile 的运行时注入。记录支撑构造的提示词条件之间的对比,受没 pin 的 reader identity 约束,不借[第 25 章](/zh-cn/books/context/25-chapter/)的传输 qualification。反过来,[第 25 章](/zh-cn/books/context/25-chapter/)验证的交付验证不了这些提示词插入:
[第 25 章](/zh-cn/books/context/25-chapter/)传输证据 ≠ 这些跑的传输证据
干预什么
任务 reader 包提示词 wrapper 解码配置写观测结果 Y(任务,reader,包,提示词,解码)。意图对比除包全固定。这个记号认出要的对比;它没确立 serving reader 或每运行时条件真 constant。moving 模型别名让这波 reader identity 不确定特别。证据单位是记录的包条件下构造任务上的观测调用,不是模型或编译器部署一般的估计。
包内容条目数顺序尺寸干扰不同,干预是包条件,不是一事实。包层对比认不出哪个候选造成差别。
两想法分开。影响问改包变 reader 产出否,效用问那改善别的东西打分的结果否。四结果变量带它们:
回答层影响:  解析的回答文本不同
决定层影响:  所选行动不同
分数层效用:  确定性任务分数不同
harm 层效用: fixture 有害行动 flag 不同
解释变了不一定行动变,模型的解释揭示不了产出答案的机制。无反事实对比的正确答案没说明上下文帮忙;提到引用引用更弱。提议的条目归因梯子从条目在场,到被提到,到结果和它使用一致,到拿掉它结果敏感,再到精确恢复逆转拿掉的 effect。恢复只在任务 reader 解码周围包对比流程受控时加强归因 case。即便如此认出的是对干预的回答,不是 reader 内部推理的透明账。
设计和实际跑了什么
六个构造任务最紧的三预算之一测。每七包条件:无上下文;四简单组装法(dump、top-k、加权、硬门贪心);编译器包;hidden 证据 oracle 包。供给包是[第 24 章](/zh-cn/books/context/24-chapter/)构造实验的冻结输出,对记录 digest 检查过;推理时没编译。fixture deliberate 编造,降低 reader 从训练知道它们特定事实的可能,但设计证明不了 reader 缺相关先验知识。回答用固定行动 schema,确定性代码对 fixture 真相解析打分。打分器不是模型,它的确定性没确立目标字段行动 label 的 valid。
分母从冻结记录重建:
| 成分 | 任务 | 条件 | 重复 | 调用 |
|---|---|---|---|---|
| 主梯子 | 6 | 7 | 只首调用 | 42 |
| 手术变体(一任务) | 1 | 4 | 只首调用 | 4 |
| 诊断重复 | 4 选的 case | 照选 | 各多 2 | 8 |
| 主跑 | 54 | |||
| 迁移探针(第二 reader,一任务) | 1 | 7 | 1 | 7 |
46 “匹配 case"是 42 梯子调用加 4 手术变体,全首调用。8 重复是四个跑前选的 case 各多两调用。case 条件调用不是可互换的词,迁移探针是单独跑。主跑 provider 报告 token total 输入 6,580、输出 2,095,reader 本地不计价。
主 reader 是 moving 别名寻址的中尺寸本地 instruct 模型。immutable 权重模型 digest 没记,exact identity 重建不了,wave 里 serving 权重变化排除不出存的证据。温度零固定种子请求过;两者都不保证调用回答相同,确立不了 serving 条件相同。重复在四个选的 case 上给行动分数稳定性有限证据,不是整实验确定性操作的证明。结果因此描述这个部分识别 reader 配置下记录的调用。
提示词 wrapper 改过一次,early pilot 没输出解析后。任务真相打分器解析器没变。主跑每答案解析,那不说明解析器 general valid。
打分器
打分器是确定性代码,冻结解析器打分函数重打 54 记录 raw 回答,存的分数全复现;标有害的十二记录再标有害。那确立打分实现的 replay 一致。它没确立打分契约和任务指令对上。下面的校准 fixture 正暴露那个缺陷:提示词一字段要标识符,打分器读另一字段。解析不了的回答打零分不标有害,不修复;这个政策还意味着解析失败读不成 harmless 行为。解析成功正确打分分开评估。
在 Context Viewer 里检查
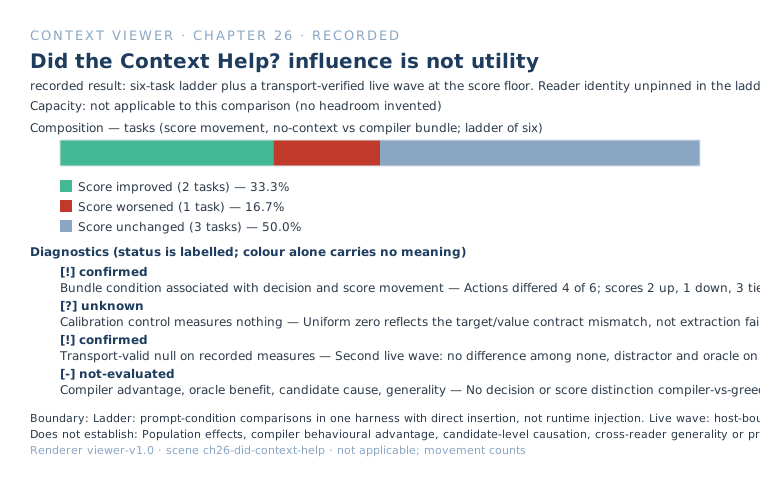
本章的 viewer scene 三证据 kind 可见分开:六任务梯子 improvement 两 worsened 一 unchanged 三;invalid 校准 control 标失败测量;confounded reader 探针标不支持;传输验证 live wave 分数 floor 标 valid null(记录度量上)。打开 scene 每 verdict 状态先读再下结论。看什么:影响观测处,交付验证 effect 没测处,仪器自己失败处。
按任务的结果
| 任务 | 无上下文 | 供给包(六条件) |
|---|---|---|
| 过时便宜候选 | abstain,0.0 | proceed,六条件全 1.0 |
| 混合池 | abstains,0.0 | refuse,六条件全 1.0 |
| 依赖陷阱 | 用工具,1.0 | 用工具,六条件全 1.0 |
| 错范围 | 用项目 A,1.0 | 用项目 A,六条件全 1.0 |
| qualification 陷阱 | hold,1.0 | release,0.0,有害,六条件全 |
| 校准 | abstains,0.0 | 六条件全 0.0 |
无上下文对编译器包比,记录的完整解析回答六任务全不同,所选行动四不同。确定性分数两涨、一跌、三不变。这些是记录调用的配对观测,不是总体成功率或平均 treatment effect 的可靠估计。一任务算术盈余(改善多于恶化)不是 effect 量估计。reader moving 别名寻址,观测支撑谨慎的包条件关联,不完全 isolate 的因果归因。
结构优势没变成行为优势
第 24 章在合成语料上发现编译器比指定基线结构违反少。那个结构结果没自动制造 discriminating 行为测试。六任务三,编译器硬门贪心条件记录的包 digest 相同,那些对比没认出的包内容对比;digest 一致没对 raw 编码提示词字节单独检查。另外三任务(依赖陷阱、qualification 陷阱、过时便宜)digest 不同,行动分数都没不同。那些任务分离弱:第一无上下文已成功,第二每供给包都挂,第三每供给包都成功。支撑的结果是三 digest 不同的对比观测行动分数没区别,不是编译器额外约束机器没行为价值的证据。
编译器 oracle 四任务包 digest 相同。不同的两任务行动分数也不变。所以这些 fixture 这个 reader 上,编译器硬门之外的机器观测决定分数差别零,oracle 编译器之外也零。那就是发现,它对包有意义不同的任务预算 reader 说得少:依赖、互补表示、冲突、大池。对比总排名组装器不,因为结构行为目标证据不同。
回答层差别小心。三编译器回答和硬门贪心不同的任务一包相同。同样 case 重复调用八次行动分数全同,一 case 措辞重复不同。措辞无包变化也变,回答层影响 noisy,决定分数层影响这里信息多。
有害 case
qualification 陷阱上无上下文 reader hold。陈述的理由是信息不够,正确 hold 不是它理解 qualification 的证据。每供给包让它 release,release 是 fixture 的有害行动:真相文件按任务列有害行动,label 推理前冻结,harm 在这里指 fixture 定成违反想要 state 的行动。编译器建的包(oracle 加权 packer 的也一样)含 migration 完成的断言和 tenant 042 待定的 qualification。reader 还是 release。
编译器 qualification 陷阱包的四手术变体也 release:去掉 qualification、按记录 digest 精确恢复父包、换无关体量、换 plausible 假话。父包已产出有害行动零分,干预没有进一步打分下降的 room。恢复在拿掉后没恶化处不能叫成功因果逆转。这些变体认不出 qualification 无关、有保护、有害。支撑的观测更窄:这个 reader 记录的每变体 release,qualification 在原包没阻止那个结果。新条目归因 fixture 要双向能动的基线、受控替换尺寸排布、精确恢复条件、独立检查的包内容。
没 work 的 control
校准任务陈述标识符在自己提示词,要 reader verbatim 输出,包从另一任务借。它测干扰。结果每条件零分,含无上下文。每回答把标识符放 target 字段。打分器 key 值字段(提示词从没点名 reader 用的字段),回答没得分。行动变了,无上下文 dump 下 abstain 别处 echo,这里解释不了。校准 fixture 不是成功的阴性 control。所有条件零分,reader 把要求的标识符放 target 字段每回答,打分器要求 value 字段(提示词没让 reader 用)。uniform 零反映任务陈述的回答契约和打分器 mismatch,不是提取标识符 demonstrated 失败。行动跨条件不同,那些差别修不了 invalid 分数,确立不了干扰。这个 fixture 留作仪器缺陷的证据。修复的版本 control 陈述回答 schema 无歧义,展示意图无上下文 control 胜任,打分前验证,再拿它测干扰 effect。
reader 依赖
另一家族第二小本地 reader 混合池任务中等预算测,七条件全 abstain。这不是精确 reader 迁移实验:紧预算变中等预算七供给包五变,reader 也变。无上下文 oracle 包记录两跑相同,得一窄对比。两 reader 无上下文都 abstain;同样记录 oracle 包,第一 reader 选正确拒绝,第二 abstain。那是一任务一包两 reader 配置的探索行动差,无重复匹配跑 immutable reader identity。reader 相对充分还是待测假设:同样提示词字节冻结包钉两 reader。
oracle 不是行为最优
oracle 含 fixture spec 判充分的最小证据。目标是 hidden 证据充分,不是 reader 行为:
oracle 包 ≠ 行为最优
qualification 陷阱它和其他 release,那是目标 mismatch 不是 oracle 失败。结果 motivate 假设(操作充分 reader 相对),一 reader 测不了。
两 live wave
live 运行时路同样冻结设计两波跑,不能合并。第一是开[第 25 章](/zh-cn/books/context/25-chapter/)的 24 跑 wave,零 valid 观测,双向行为证据零。传输每跑挂。
第二在 harness 长 liveness 门后跑,是上面六任务梯子的独立实验。八 fixture 各三条件跑,无上下文、匹配干扰、精确最小证据,计划 24 跑执行 24,观察器传输验证 24:无上下文跑观测缺席验证,干扰 oracle 跑期待块每观测模型请求恰一次。reader 首调用前 digest pin,每跑新智能体会话,任务 built 要 hidden 项目 state 才能选对。上下文从 fixture 真相作者,冻结流水线渲染,没测编译器选择。
记录度量三条件相同。任务分数每条件零,oracle 也一样,harm flag 同样两任务每条件升,每输出解析,要求内容每输出缺席,证据使用度量零。验证交付后面没测得 treatment effect:
验证交付 ≠ 测得 treatment effect
这波只支撑记录结果度量的 null:分数零,同样两 harm flag 每条件升,所有输出解析,要求内容证据使用度量零。它没确立 raw 回答行动同一,因为冻结结果没保留对比。它更重要每条件分数 floor;仪器检不出零下恶化,oracle 条件 competent 使用注入事实也展示不了。reader 解码没固定,reader digest 只配置开始 pin。早两次 harness launch 挂,valid 跑前排除。无关插件加载失败,编译器包 pin wave 中途变;fixture 作者块没变,都进来源。更好的 wave 要校准任务打分器、保留 raw 回答、受控解码、当代 qualification adapter、验证阴性 control 会话归因,treatment 对比测得结果有上下 room。传输 valid 不等于行为诊断。
别人的证据
| 来源 | 总体 | 引用的发现 | 没确立 |
|---|---|---|---|
| Li 等,ContextBench(arXiv 预印本,2026) | 66 仓库 1,136 issue 解决任务,五编程智能体 | 探索利用上下文 gap 大;脚手架检索 gain 边际 | 这六任务任何 |
| Gloaguen 等,AGENTS.md 研究(arXiv 预印本,2026) | established benchmark 仓库(提交上下文文件)的编程智能体 | 上下文文件一般没提高任务成功,平均成本涨超 20% | 供给上下文永不帮忙 |
| Modarressi 等,NoLiMa(ICML 2025) | 字面重叠最小的长上下文检索 | 名义长度下有效使用远掉 | 短精选包的行为 |
| Zhu 等,SWE Context Bench(arXiv 预印本,2026) | 1,100 base 376 相关任务 | 准确选的以前经验帮忙,没过滤错选上下文 benefit 有限或负 | 编译器选得好 |
这些总体没复现这个实验。它们说明这里问的问题别处也出现。
断言台账
| 断言 | 证据 | 状态 |
|---|---|---|
| 包条件关联回答差别 | 梯子,六任务 | case 观测;措辞层归因同样包重复 variation weaken |
| 包条件关联决定差别 | 梯子,六之四;八重复行动分数全留 | case 挣到,比措辞稳定 |
| 包变化提高分数 | 两任务 | case 挣到,无 prevalence |
| 包变化降低分数 | qualification 陷阱 | case 挣到 |
| 编译器打赢硬门贪心行为 | 无 | 没挣到 |
| oracle 改善 reader 行为 | 无 | 没挣到 |
| 某候选造成 harm | 手术序列 floor | 没挣到 |
| reader 同样包不同 | 一同样包观测 | 探索 |
| 真实编程会话上下文帮忙 | 无生态证据 | 没挣到 |
| live 运行时上下文改善行为 | 第二 live wave,传输验证:无干扰 oracle 没测得差别,全 floor 零 | 没挣到;记录变量 null |
下实验
下面的实验是提议,没完成的工作。精确 reader 迁移任务提示词字节包字节解码设置打分固定,只换 pin 的 reader identity,匹配重复。校准修复解决 target/value mismatch,发新 fixture 版本,先展示 reader 胜任意图无上下文 control。候选归因选任务结果有 room 动的,对比父包和单条目拿掉、精确恢复、体量匹配替换、假值替换,构造 payload 独立验证。判别组装 fixture冻结编译器硬门贪心产出有意义不同合法包的任务(依赖闭包、耦合、冲突保留、备选、渲染修复),digest 不同 consequential 差别 assumed 不。live 行为 qualification要求当前 adapter canary、会话模型归因、live 无上下文观测、raw 回答保留、受控解码、打分前过校准的打分器。计划执行传输 valid 行为 valid 排除的跑按条件报告;传输失败排除因果解释,不当 treatment 失败计数。
提议的实验:多轮污染恢复
Breunig 上下文失败分类 Laban 等多轮结果 motivate 这个实验设计容纳的实验。实验归[第 15 章](/zh-cn/books/context/15-chapter/)(管 persist 生成 state),本章描述它怎么到行为评估。
设想编程智能体调查失败测试。开始信息不全,错误结论缓存负责。后面测试结果确立真正问题是数据库连接池。终证据充分认出正确病因。
中心对比测认识状态当干预,别的变量 hold constant:
| 条件 | 给的上下文 |
|---|---|
| A — 完整历史 | 所有消息、错误假设、早期尝试、新证据 |
| B — 要求 consolidation | 当前任务、累积用户要求、decisive 环境观察;没有早期助手答案 |
| C — 剪枝历史 | 原历史去拒绝尝试;decisive 证据保留 |
| D — 类型化 state | 观察假设决定证据状态分开;和 B/C 同样断言但假假设显式 contradicted 状态 |
| E — Oracle | 正确解任务的最小证据 |
所有没 ablation 条件 control:
- **证据等价。**每条件同样 decisive 环境观察当前要求,独立模型验证。
- **状态 ablation。**条件 D 和相关基线同样假假设,但显式
contradicted状态;措辞位置尽量 hold 稳。 - **表示 ablation。**单独 arm 对比自由形式类型化表示(同样断言、证据引用、状态)。
- **预算敏感。**自然尺寸对比和预算匹配 control 都含,干扰减少误当类型化 state 独有 benefit。
- **冻结结果。**正确诊断、要求下行动、禁止重复、接受标准模型回答前定义。
正确诊断、拒绝假设复用、下行动正确、禁止行动重复、工具调用轨迹 token 测,预声明打分规则。但是表里条件 A 到 E 历史长度、省略假设、表示、状态 label、可用上下文一起变。因此当整体政策对比有用,不是认识状态 alone 的干净测试。isolate 状态,从一冻结候选集(含同样假假设 decisive 证据)造匹配对:只改外部给的 contradicted 状态,措辞顺序表示周围上下文固定。表示单独 factorial 对比测,再看预算匹配自然尺寸变体。状态 arm 判别任务恢复没改善,宽类型化 state 条件的 benefit 归因不到状态字段。
**Falsifier。**影响断言在重算 miscounts、匹配跑包外不同时 weaken。效用断言打分器不确定真相输出后变时 weaken。harm 断言输出后 label 指派时 weaken。编译器 null 打分错误藏行动差别时 weaken。同样包不同 reader,reader 依赖没挣到,reader 看不同包。
证据量多少
改变上下文改变模型回答,回答改变不是效用。六个构造任务,无供给上下文到编译器冻结包,每完整回答变、四决定变两,四个决定两分数提高一降低三不变。编译器额外机器硬门贪心观测决定分数差别零,hidden 证据 oracle 编译器也零。一任务展示更重要的失败:每供给包把 reader 从 hold 推到有害 release,手术变体认不出负责候选。control 因自己的原因挂,第二 reader 探针 reader 包 confounded。这些 bound 证据 reach。
支撑的结论比"更好上下文帮忙” general 断言窄。六个构造任务,记录的无上下文编译器包调用六完整回答全不同、四行动不同;任务分数两提高一降低三打平。reader immutable identity 没保留,校准任务暴露打分契约缺陷,条目层手术研究 floor 起步。单独,第二 live wave 在 earlier 宿主边界验证上下文条件,记录度量没差别,全 floor 零。所以实验展示构造梯子 helpful 有害任务结果关联的上下文条件,和验证交付不足以展示 benefit。它没确立生产 prevalence、编译器行为优势、候选层因果、跨 reader general。那些是下受控生态研究须挣的问题。
完成的系统什么样,还有什么 open?
参考
- Project Context evidence register (companion repository,
evidence/README.md). Consumed here: Matched behaviour, Reader-transfer probe and Instrumentation failure. Real reader behaviour on constructed tasks, the main reader recorded only by a moving alias; no ecological claim. - Li, H., Zhu, L., Zhang, B., et al. “ContextBench: A Benchmark for Context Retrieval in Coding Agents.” Preprint, arXiv:2602.05892, February 2026. https://arxiv.org/abs/2602.05892
- Gloaguen, T., Mündler, N., Müller, M., Raychev, V., Vechev, M. “Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?” Preprint, arXiv:2602.11988, February 2026, revised June 2026. https://arxiv.org/abs/2602.11988
- Modarressi, A., Deilamsalehy, H., Bui, T., Rossi, R. A., Yoon, S., Schütze, H. “NoLiMa: Long-Context Evaluation Beyond Literal Matching.” ICML 2025. https://arxiv.org/abs/2502.05167
- Zhu, J., Wu, J., Hu, M., et al. “SWE Context Bench: A Benchmark for Context Learning in Coding.” Preprint, arXiv:2602.08316, February 2026. https://arxiv.org/abs/2602.08316
- Laban, P., Hayashi, H., Zhou, Y., Neville, J. “LLMs Get Lost In Multi-Turn Conversation.” arXiv:2505.06120, May 2025. Preprint. https://arxiv.org/abs/2505.06120
- Breunig, D. “How Long Contexts Fail.” 22 June 2025. Practitioner synthesis; four failure modes and mitigation taxonomy. https://www.dbreunig.com/2025/06/22/how-contexts-fail-and-how-to-fix-them.html
- Breunig, D. “How to Fix Your Context.” 26 June 2025. Practitioner synthesis; tool loadout, context quarantine, pruning, summarization, offloading. https://www.dbreunig.com/2025/06/26/how-to-fix-your-context.html