上下文是什么意思
把上下文与提示词、上下文窗口、会话状态、记忆、检索,以及系统可及的更大信息宇宙分开。
设想一个具体的晚上。开发者让编程智能体修一个失败的测试。键入的消息只有十一个词:“the checkout test fails after my last commit, please fix it.”
这十一个词背后,是比请求大得多的信息组织。仓库里有几十万行代码。版本控制历史里有上次提交和之前每次提交。持续集成日志里有实际失败输出。打开的编辑器里有开发者正在看的文件。智能体的工作目录里有 shell 历史、环境变量和配置。本节早些时候,开发者粘过一条报错轨迹,智能体跑过两次搜索,linter 产出三条没人读过的警告。
必须行动的模型不会自己检查仓库、日志或编辑器。它收到周围软件组装的渲染调用:指令、选出的历史、文件摘录、工具定义,以及其他准入材料。运行时还可能暴露工具,让模型以后请求更多信息,但那些未来的观察还不是这次调用的一部分。也许当前请求含 40,000 输入 token;也许 4,000。(这些数字是示意。)差别反映组装选择,受模型与 provider 限制,能改变模型下一步做什么。
这就是本书调查的情形。“上下文”一词日常指六种不同的东西:用户提示词、聊天记录、模型的窗口大小、检索文档、系统记忆,有时是整个应用状态。这些不是同一对象。不分开它们,严肃的工程不可能,因为每次测量、每次干预都瞄准错误的层。
四个不是一回事的东西
从完整的信息宇宙开始。叫它可用信息(available information):周围系统潜在可及的一切。源文件、数据库、网页、以前的会话、同事笔记、传感器 feed、vault 里的秘密。可用信息能比单次调用大得多,可以包括系统技术上够得着、但没授权用的材料。可用不蕴含许可、相关性或准入。实际调用装不下整个信息世界,大多数可及材料对任务不必要。
收窄到系统跨交互保留的东西。叫它会话状态(session state):周围软件从一步 persist 到下一步的信息,模型当前看不看得到都算。磁盘上的对话历史、缓存的工具结果、智能体上轮写下的计划文件、认证 token、昨天工作的压缩摘要。会话状态在调用之间存活,很多可能再也不展示给模型。它是系统对任务至今的记录。它和记忆书里的记忆不是一回事:历史、缓存结果、计划、摘要都能是会话状态,而不属于意在改变未来行为的 retained 知识。
再看模型现在实际收到的东西。这就是上下文(context),本书全书只用这个意思:为某次计算提供给模型的信息。四样东西不是严格嵌套,窗口和其他三样不是一类东西:它是上下文的容量约束,不是另一摞信息。有些上下文从会话状态或其他可用信息直接复制或选出。另一些在组装里变换它们而产生,比如指令从模板加运行时状态渲染出来。文件在磁盘上、本次调用没收录,它是可用信息,也可能是会话状态,但它不是上下文。上轮对话被摘要、摘要收录了,摘要是上下文,原轮次不是。调用之外的信息,这次计算里模型用不了,再相关也一样。它只在系统把它带到后面时影响后面的计算,比如存成笔记或工具结果。
最后把容量和内容分开。**上下文窗口(context window)**是容量:约束一次模型调用的有界预算,按 token 计。Provider 记账方式不同。比如 OpenAI 的文档说限制覆盖输入、输出和推理 token,它把文本生成请求描述为独立无状态,除非调用者重供状态或用它的对话状态功能。别的运行时用别的方式存或重建状态。一般概念只是每次调用有有界预算。窗口告诉我们模型能收多少。它不说哪些位值得在里面。
紧凑地说,运行时把信息从调用外搬到调用内,窗口约束里面装多少:
    flowchart TB
    subgraph avail["可用信息"]
        direction LR
        S["会话状态<br/>在步骤间持久化"]
        O["其他可用信息<br/>文件、存储、以前的会话"]
    end
    R("运行时组装<br/>选择、排序、表示")
    C["上下文<br/>这次计算收到的东西"]
    W(["上下文窗口<br/>约束这次调用的容量"])
    S --> R
    O --> R
    R --> C
    W -.-> C
    C --> M["模型"]
外框的材料模型不会自动看到。它收到为这次调用组装的上下文。有工具时,它可以请求更多观察;结果只在经运行时进入后面的模型调用。窗口约束总调用预算,包括 provider 记账规则下预留的输出或推理 allowance。组装可能变换源材料而不 verbatim 复制,所以渲染的上下文需要回源的来源。
任何两样搞混都有特征错误,目录在下面。最顽固的混淆是提示词。用户消息是包里最显眼的一项,团队打磨最多的也是它,所以 attention 全去了,而调用的其余部分(通常是大部分)没人检查。bundle 其他内容组装草率,提示词工程再 skilful 也补不回来。
一个可建造的定义
本书的 primitive,说一次,到处用:
上下文是为某次计算提供给模型的信息。
这句话里三处有分量。“提供"标出上下文是组装过程的产物,信息在其中被选择、排序、表示。“给模型"标出影响边界:上下文是一次推理步骤的输入侧,不是系统的信念或用户的意图。“为某次计算"标出范围:上下文按调用算。下次调用可能带不同的包,跨调用必须 persist 的东西须 deliberate 带过去。合起来,上下文是存在的信息和能参与这次推理的信息的边界。本书大半研究边界上面的机器和下面的行为后果。
这个定义是本书的操作约定, grounded 在主流模型接口暴露的按请求输入。Provider 文档支持渲染输入(指令、工具定义、历史、有时媒体)的存在;它本身没确立每家 provider 用 context 一词都是精确这个范围。比如 OpenAI 的提示词缓存文档把可缓存单位描述为模型的"full rendered context”,包括 provider 指令、开发者消息、工具定义、对话历史。Anthropic 工程团队把上下文定义为采样语言模型时纳入的 token 集,工程问题是在模型约束下优化那些 token 的效用。本书拿这个共享的接口现实当地基,上面建工程 discipline。
容量、内容、表示与时间
定义固定了就能分解问题。三个问题描述任何一个上下文包。第四维时间描述包及其信息跨计算怎么变:
                 上下文
                    │
        ┌───────────┼───────────┐
        ↓           ↓           ↓
      容量         内容         表示
     多少?      哪些位?     怎么表示?
容量问调用能带多少:token 预算、输出 headroom、推理 allowance。它由模型和运行时定,不由任务定。内容问可用信息里哪些位准入了:哪些文件、哪些历史、哪些指令、哪些工具结果。表示问准入的位怎么表示:raw 散文还是结构化记录,完整日志还是摘录,精确工具 schema 还是转述,按时间还是分组排序。
分解的意义是包可以在一轴 adequate、另一轴 inadequate。这是诊断断言,不是说轴统计独立:比如更丰富的表示耗容量。包能容量宽松而内容错:有 bug 的文件被排除,误导的日志被纳入。能内容对而表示是模型 mishandle 的形式,比如一大片没区分的日志文本,而小表失败断言就够。能这轮三轴 excellent、下轮错,因为会话往前走了而包站在原地。容量失败表现为截断或拒绝。内容失败产出漏掉 decisive 证据的答案,有时无可见迹象。表示失败让正确的信息技术上在场但难用。这些是特征可能,不是可靠签名,没有一个是测得的比率。学会分开三者还是半本书。
分解还组织后面。第一部分剩下(第 2–7 章)贴着观察:测量模型实际收到什么,揭开它的隐藏层,把容量当预算,检查更多内容和草率排序 degrade 行为的证据。后面部分讲缩减、外化与回忆、来源与表示、治理,最后组装一个包、交付、问是否有帮助。Introduction 给全图。
四维度证据不均等。容量由 provider 记载。位置与长度的长上下文 effect 来自文献。本书自己的测试小而合成,只涉及组装交付后的内容与表示(第 23–26 章)。关于时间的话 rests 在工程推理与文献。本章定义维度,不实验确立它们。
时间是计算之间包发生的事。会话里上下文随工具返回观察而累积;随世界在底下变化而过时;文件重读时被替换;历史摘要时被压缩;截断时离开窗口,有时经重检索回来;被 harness 逻辑重排;智能体自己生成计划、笔记、中间 artefact 成后面步骤的输入。无视时间的上下文定义描述的是运动物体的单张照片。本书把上下文当运动物体,一次计算一个。
上下文是对行为的干预
为什么坚持按计算精确?因为本书关于方法的中心断言从它跟出来:
**本书假设。**模型任务固定,只改上下文包、其他全 hold constant,行为分布变了,变化可测。
这是 general 假设,不是既定背景。它重要因为把上下文从 vague 背景条件变成实验干预:deliberate 变动并测量后果的东西。
本书有一条窄结果与它相关。六个合成任务上,一个 reader 模型温度零、一预算,只改包,reader 解析出的动作每任务都变(第 26 章。那是关于那个 setting 的结果。它没展示采样下行为分布,没展示别的模型、别的预算、真实任务,也没展示变化帮忙了:分数有的任务提高、一个变差、几个不变。
假设的反事实要小心陈述。模型采样时行为跑间本来就变,输入相同也一样,所以一包失败、一包成功一次证明不了,而 general 断言是跨重复试验的分布。本书自己的对比走另一条路。reader、提示词、解码配置固定,确定性打分,压住采样这个实验变量,结论限在那个配置,不经重复采样估计分布。两种路 discipline 一样:没有它,每个观测到的改善都可疑,每保留的 token 都是迷信。
假设还有锋利的边。两包在指定测试下观测行为 indistinguishable,测试没检出差别的 effect。这不是等价的证明:评估可能不敏感,样本可能太小,相关失败可能缺席。proper 结论 bound 在模型、任务、解码配置、测量、试验数。反过来,去掉一条指令性能塌了,那条指令挣了它的 token。null 结果收窄需要什么。它没证明机制无用,只说明这里没帮忙;本书后面的规则是机制修了 demonstrated 的失败、质量成本延迟复杂度可接受,才进架构。本书里效用断言须在陈述条件下对比支撑,只在那些条件下成立。
这个标准排除几个诱人的非实验。更小的提示词不是更低成本的证据,除非成本测了。流利的摘要不是信息保留的证据,除非信息留存测了。包里躺着检索文本不是行为改善的证据,除非和没它的包比行为。每个混淆在后面章节附着具体机制重现;抵抗它们的 discipline 在这里确立。
同样的分开,代码之外
编程智能体是本书的 running 例子,但分开处处成立。拿研究助手问:“检索增强生成降低幻觉率吗?“可用信息包括整个文献、开放 web、用户私有文档库。会话状态包括已讨论的三篇论文和用户说过的偏好新工作。下次调用的上下文更窄:系统指令、当前问题、前段交流的短摘录、检索器返回的五段,其中两段互相矛盾。上下文窗口是所有这些加答案位置必须装下的 token 预算。
同样的错误这里都有。相信检索文档就是"模型知道的东西"的团队,会惊讶答案 miss 了检索到、调用前被砍的段落,或上轮会话状态里有、本轮没重供的东西。相信会话状态就是上下文的团队,会惊讶答案没反映用户说过的偏好——harness 存了,当前包没收。每个惊讶都是地址精确的类别错误:东西可用,或 persist 了,但这次计算没提供。
五个混淆及其症状
每个 conflation 在实践里有可认的症状,诊断上下文失败从定位哪个对象出错开始。
- **可用信息误当上下文。**指望模型用从没展示的信息:没打开的文件、没粘的日志、没人查的数据库行。症状:失败明明任何调用都避不开,反驳却是"它明明能访问仓库”。
- **会话状态误当上下文。**指望模型记住系统只是存下的东西。它只看到 harness 重供的东西,重供涉及截断、重排、摘要。症状:十轮前的偏好、决定、纠正消失了而惊讶。
- **上下文误当窗口。**大 advertised 上限读成把检索到的一切都装的许可。症状:包长到装下而不是长到 work。装进窗口不保证模型有效用里面的一切;后面章节 review 证据及其 limit。
- **窗口误当上下文。**容量规划代替内容选择。症状:报得出模型 token 上限,说不出自己指令耗多少 token 的团队。
- **上下文误当提示词。**力气花在用户消息的措辞,包的其余没人检查。症状:精心措辞的指令被同一调用里三位置之前的过时笔记 contradict。
很多自称提示词工程的调试,其实是在这些层之间没承认的搜索。
一个包,八轮之后
时间值得 concrete 的例子,因为静态图低估它。回到 checkout-test 会话。下面的数是为说明编的,不是测量。第一轮带用户消息、项目文件、工具定义、一源文件:也许 9,000 token。到第四轮,两工具结果与重读文件加入;包 22,000 token,同一项目文件第四次出现。第六轮 harness 摘要最早轮次,8,000 token 历史换成 900 token 没人验证的 condensation。第八轮智能体往工作 state 写计划笔记,harness 从此每调用都收。八轮用户的话加起来几百 token。包长大几倍,成分反复变,长出自生成层,用户没发任何新请求。
本书后面的每机制都是对这个运动对象的操作:什么进入、什么必须留存、什么可以掉保真度、什么不再重要、什么回来早了。操作不同,前提共享。它们作用在渲染的包上,不作用在谁的印象上。
书怎么比包
尊重这个标准的最小对比:拿外部可检查结果的任务,比如必须变绿且不弄坏别的的失败测试。模型、解码设置、任务固定。构造两包:一含任务描述加失败文件,一同样加 plausible 相关但不必要的文档。比结果、渲染输入 token 总数、工具调用变没变。
这个双包设计是方法的说明,没当独立实验跑。本书跑的对比在第 26 章,相关但更大而不同:六个合成任务,每任务几个包条件。
对比在受控 regime 下结果或轨迹不同时,证明上下文起作用了。 regime 下没检出差别是 null 观测,不是包行为可互换的证明。随机解码下,那意味着把 effect 和跑间 variation 分开。固定解码下,那意味着那个配置下可复现的差别。记录的 trial 里两样都不不同,多余文档耗了输入 token,那次 trial 里没检出行为 benefit;重复 trial 或更强的测试可能改变结论。阴性发现和阳性发现一样值钱,这是本书只按测得的根据保留、修订、删除机制的方法的第一个实例。
两条设计规则在后面每次对比重现。第一,模型任务 hold constant,只变包。模型版本、解码设置、上下文一次全变的对比归因不到上下文,这种 confounded 对比本书见一次拒一次。第二,行为从外部可检查结果与记录轨迹读,不从模型自己说帮忙没帮忙。问模型多余文档有用吗,得到流利证词。带着和没带着各跑任务,得到证据。
注意这个设计不需要什么:不要检索系统,不要摘要器,不要缓存分析,不要智能体架构。要的是渲染两精确包、数发生什么的能力。那能力是下一章的主题,比听起来难拿。
在 Context Viewer 里检查
本章的 viewer scene 把开篇区分做成声明的 fixture:六个可用来源,一次计算准入包三个。打开 scene 检查哪些条目在当前上下文里、哪些可用而在外。看什么:跨步骤携带的会话状态和这次组装的上下文的线。这是词汇的构造说明,不是测量;它不说哪种准入模式典型或是否有帮助。
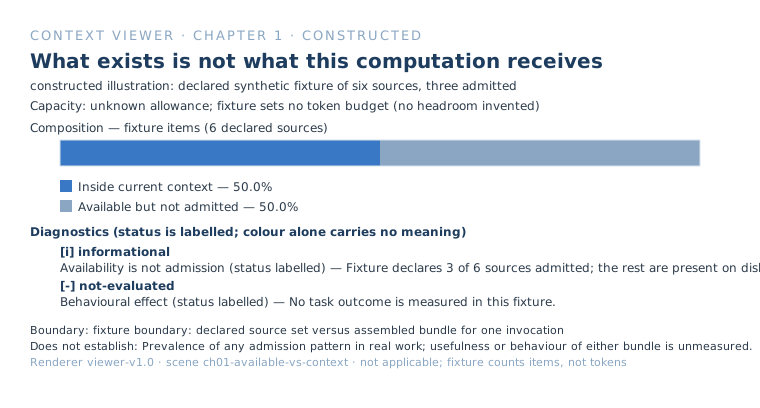
边界
本章确立词汇,不确立机制。相邻学科只取到上下文需要的程度。
提示词工程管指令与内容的表达。上下文工程还管什么准入、怎么表示、排序、治理、交付。两者重叠,细致措辞的重要一点没减。point 是措辞作用的包里别的内容也重要。
记忆管 durable retained 信息改变未来行为的能力。记忆记录 mere 存在不是上下文;准入计算时才是。会话状态同样不自动是记忆。durable 记录的存储、consolidation、遗忘归记忆书,记忆在这里是上下文来源。
检索供给候选信息。本书拿检索结果当候选,集中做后面的准入、表示、组装、交付、评估。检索与组装实践里可能互动,边界是概念的不是固定顺序。排序、索引、嵌入归嵌入书和检索书。
智能体与工具在这里重要两原因。智能体反复消费上下文并生成潜在未来上下文,工具定义耗窗口。工具结果在后面的计算收到前是潜在上下文。智能体架构在本书范围外,评估与推理只以裁判上下文干预的手段和跑它们的 substrate 出现。
本章压缩成一想法,就是四分法。可用信息是存在的东西。会话状态是系统保留的东西。上下文是这次计算收到的东西。窗口是它能收多少。后面的每章都是给定第四样、前两样从外面压进来时,怎么明智选第三样的调查。信息存在,有的 persist 了,有的被选被表示,一次计算收到它。收到的就是上下文,窗口约束它,它随时间变,改变它可能改变行为。
这些在收到的上下文可见前都用不上。本书后面研究的每操作都作用在渲染的包上,不作用在谁的印象上。所以下个问题是实践的:
我们怎么知道模型实际收到了什么?
不是用户可见的提示词。是整个渲染调用。
参考
- Anthropic Applied AI team. “Effective context engineering for AI agents.” Published 29 September 2025. First-party engineering writing. Defines context as tokens included when sampling; smallest high-signal set as guiding principle. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- OpenAI. “Conversation state.” Official documentation, verified September 2026. Stateless per-request model; context window covers input, output, and reasoning tokens. https://developers.openai.com/api/docs/guides/conversation-state
- OpenAI. “Prompt caching.” Official documentation, verified September 2026. Cacheable unit is the full rendered context. https://developers.openai.com/api/docs/guides/prompt-caching