表示是上下文的一部分
该模型可见的信息取什么表示,组织编码怎么改变模型能做的操作、保留的区分、消耗的资源?
这里有个一 fixture 建的说明 case。migration 用 PostgreSQL,标识符 01947,测试套件 A 还 block,团队在 staging 事故后拒绝 SQLite fallback。同样声明的事实资格渲染一次散文、一次 label 记录。问没解决的 migration 标识符,模型在记录里比散文里嵌的数字定位更可靠也可能。问为什么拒绝 SQLite,两种表示都保留理由及其 qualification 就一样好。记录漏掉那个 qualification,对比不再 isolate 表示:它还测缺失信息。这个区分是本章须看住的问题。
内容对象和实验的意图义务 hold 固定,具体输入在说相关选择丢失不同前要独立验证。两表示满足同样冻结义务时,模型行为差成测试条件下关于呈现的证据。一边丢要求 qualification,变换失败在模型跑前已在。本章是区分那些结果:
信息同一 ≠ 表示同一
第 12 章确立一内容对象能有几种满足不同保留义务成本的合法表示,这是选择不是保真梯子:
表示选择 ≠ 保真度
本章问这种表示里的组织编码对算子做什么。第 14 章拥有准入什么,第 17 章拥有工具暴露什么。权威性新鲜度范围归第 19–21 章。这里的问题是:
该模型可见的信息取什么表示,组织编码怎么改变模型能做的操作、保留的区分、消耗的资源?
信息、表示、序列化
    flowchart TD
    U["源信息<br/>或 fixture 典范 state"]
    S["语义表示<br/>什么结构显式"]
    Z["序列化<br/>具体的模型可见编码"]
    T["模型可见 token"]
    M["模型"]
    U --> S --> Z --> T --> M
第一框要小心。实验里实验者定义 fixture 典范 state,几个渲染从它生成的语义对象。真实信息不一定有无表示的对象。来源以自己的形式表达信息,映进另一结构本身要解释:
典范 fixture state ≠ 无表示真相
语义表示决定哪些区分关系分组显式。序列化是那个表示具体的模型可见编码。候选在组装前带序列化。渲染包是准入条目排序包装组合后组装器([第 23 章](/zh-cn/books/context/23-chapter/))产出的后面 artefact;它的可见分隔 label 本身影响解释。[第 2 章](/zh-cn/books/context/02-chapter/)的观察边界捕获宿主组装形式,不暴露 provider 终渲染,本章不等同两者。保留义务指定变换须留存的区分,含当前问题之外的义务。
语义家族按显式的属性定义,语法不是家族:
| 语义表示 | 显式的属性 | 序列化 |
|---|---|---|
| 叙事 | 语言承载的关系 | 散文、提纲 |
| label 记录 | 字段 identity | 普通键值文本、JSON 对象、XML 记录 |
| 表格 | 跨行重复的 schema | Markdown 表格、CSV、HTML 表格 |
| 关系表示 | 类型化关系与端点 | 行三元组、JSON 对象、CSV 边 |
| 混合 | 几种形式,各有声明的操作 | 任意组合 |
序列化不只是标点。JSON 到 XML 改变字段顺序、重复 label、嵌套、转义、类型表达、token 化、边界显著度,同样语义 schema 不蕴含同样的模型可见 cues。这就是它要自己实验的原因。
三拒绝让层次干净。表示不是范围:完整记录和它的精确 span,完整文档和它的精确 span,范围不同不一定表示不同。更小范围不自动低保真。结构不是正确:JSON 对象 well-formed 也错,段落没结构也对。显式和正确是独立属性:
schema-valid  ≠  语义正确  ≠  义务完整
显式关系  ≠  来源支撑的关系
在 Context Viewer 里检查
本章的 viewer scene 同样 migration 事实渲染四种——散文、label 记录、紧凑笔记、定位器——对四冻结义务检查。打开 scene 先读义务表再 judge 任何形式。看什么:每渲染留存哪些义务,紧凑笔记丢的 qualification 为什么是损失不是紧凑。这里等价义务相对;没模型跑,行为预测不跟。
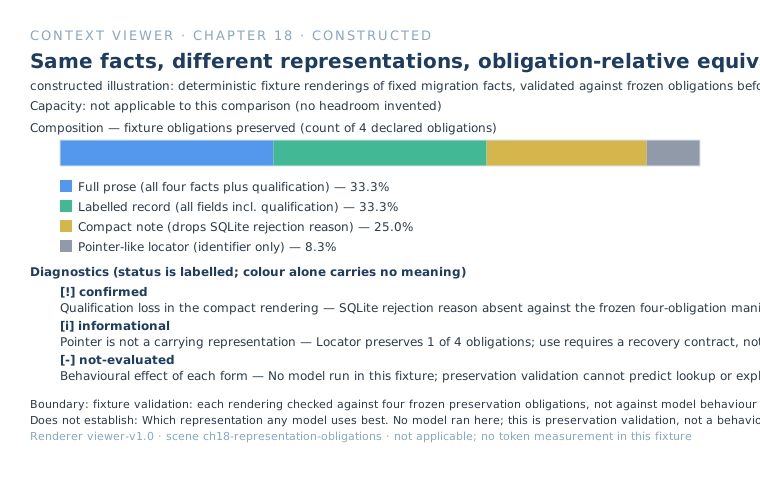
等价要义务
说两渲染带同样的信息藏了选择:原子事实、关系、qualification、来源、时间状态、不确定、操作 affordance 是不同的保留要求。开篇例子里,丢理由 qualification 的记录和散文不满足同样的义务,即使两者都保留 migration 标识符和 headline 决定。这对适合测变换损失,不适合受控断言只表示变了。
等价永远是声明的保留义务下的等价。
同样原子事实 ≠ 同样表示的信息
事实清单确立原子保留。它本身确立不了和算子相关的每关系解释留存否。fixture 声明的义务含精确值、实体 identity、关系方向、qualification、状态、来源、时间排序、不确定、null 和缺席的区分、冲突、来源边界。不用 fixture 全要。
两后果跟出来。清单通过只对清单里冻结义务确立等价(清单覆盖 bound 等价断言),清单通过 ≠ 语义同一。确定性渲染确立复现性,仅此而已,确定性 ≠ 无损,确定性 ≠ 语义等价。意图无损不是 demonstrated 等价。
先操作,后格式
模型做的操作含精确查找、记录对比、过滤、聚合、关系跟随、理由解释、更新应用、矛盾检出、来源保留。优化模型可见表示前,决定哪些操作改由确定性运行时代码做。那个选择看操作完全指定否、要求的来源代码够得着否、实现可检查否。第 17 章说明生产者侧代码减少进上下文的东西;它没确立每查找过滤对比放模型外更好。为可避免的模型步骤优化表示可能解错问题。
留给模型的操作,效用关系:
表示效用操作相对。
还看模型任务上下文长度数据尺寸周围包序列化要求精度输出要求。标量不定,无操作点名不宣布表示最好。
有的机制 plausible 还是假设。label 字段帮精确 state,因为字段 identity 显式。表格帮跨重复记录对比。类型化关系让遍历的端点方向显式。叙事用更少 moving parts 带 qualified 理由。每种隐式不是缺席:散文陈述关系,三元组只是固定结构编码关系 identity。有用的机制能是 label 字段不是大括号,键值文本和 JSON 当同样记录的单独序列化正为这个。
结构天生不去 nuance。schema 带决定理由 qualification 反事实证据,精确保留也行。它省略的东西能擦掉:
schema 省略  能变成  语义省略
表示家族能力  ≠  实例保留
表示因果 qualification 的记录家族没错,错在丢字段的渲染器。
结构还制造区分。来源散文读"the service may have failed after migration",转成 failure_cause: migration 把试探时间关联变成断言因果关系。生成的字段更显式,认识状态和关系类型都改了。schema 完全 valid,填充的实例没支撑;验证须对来源比对断言 qualifier,不只解析结果:
结构显式化 ≠ 发现结构
别的词汇要边界。图数据模型、图序列化、图算法分开:给模型三元组不等于跑图推理,运行时不支持抽象图就没有模型收到的抽象图。表格花 token 编码二维排布,经 header 分隔重复行结构,紧凑表格不因此好读,加位置依赖、header 依赖、null ambiguity、转义、行边界 ambiguity:紧凑 ≠ 好解释。
外部证据确立什么
这些都没在本书 workload 上测量。
| 来源 | 证据类型 | 总体/任务 | 验证的断言 | 本章用 | 没确立 |
|---|---|---|---|---|---|
| Sui 等,“Table Meets LLM”(WSDM 2024) | 同行评审 benchmark | 七结构理解任务(比如格查找、行取回、尺寸检出),GPT-3.5、GPT-4 | 输入格式、内容顺序、role 提示、分区 mark 变过;作者报告表格数据集上结构提示 gain | 呈现边界 cues 改变表格任务性能 | markup HTML 显式结构 general 更好;当前模型任何 |
| Li 等,“LongTableBench”(Findings of EMNLP 2025) | 同行评审 benchmark | 5,950 实例,七表格格式,十八 domain,128K token 内,52 个模型 | 作者报告只有最强模型随长度格式多样 robust | 格式 effect 和模型任务长度互动 | 赢的格式 |
| Lepagnol 等,“Format Matters”(LREC 2026) | 同行评审,输出侧 | 槽填充 NER 的 JSON XML 行内键值输出,13 开源模型 | 格式选择显著波动(2–46 F1 点),看模型数据集 | 语义目标固定,格式模型任务还互动 | 任何输入格式优势 |
| Anthropic 提示词指南 | 厂商指南 | Claude 模型提示词工程 | XML 标签分开指令上下文例子输入;文档包来源 metadata | 显式边界层级是推荐 practice | XML 打赢 JSON Markdown 散文 |
| OpenAI 结构化输出 | 厂商 API 文档 | schema 约束生成 | 回答贴给的 JSON Schema;拒绝编程可检出 | 类型化应用边界 | 结构化输入推理更好 |
| MCP 草案 spec | 协议 spec | 工具结果 | 结果装文本图像音频资源链接嵌入资源;structuredContent 按 outputSchema,兼容序列化 JSON 放文本块 |
工具边界实际表示选择存在 | 那些形式信息等价 |
这些来源支撑的结论窄。表格输入 benchmark 说明测试模型任务上的表示呈现 effect;输出格式研究展示独立输出侧敏感,不能当输入理解的直接证据。厂商指南确立推荐 practice,API 协议文档确立可用机制,不确立行为改善。研究有的条件格式和其他呈现因素一起变,报告的 gain 不一定归因序列化 alone。MCP 资源链接指向返回 payload 外的信息,不等于全文返回那个信息。
Fixture 与工程等价
让模型把散文改写 JSON 当等价,实验和转换质量搞混,改写省略 mutation 添加。本章 fixture 反转流水线:
典范 fixture state
    ↓
任务家族与保留义务(冻结)
    ↓
确定性渲染器
    ↓
保留验证
    ↓
冻结,模型跑
义务渲染前、任何模型结果看见前冻结。看结果后加义务(因为它 favor 一表示)是缺陷。
fixture valid 模型评估前、预测结果独立评估。验证检查每渲染满足哪些冻结保留义务,对比的每条件有没有资格,任务练没练意图操作,渲染 accidental 泄漏答案否。难度可答性不用实验要解释的模型结果检查。valid 决定排除规则结果检查前冻结;要求义务挂的表示照实记录,不静默修 favor 假设。再:
意外结果 ≠ fixture invalid
预测的优势没出现,那就是结果。为凑期待 split 重建 benchmark 毁掉实验。
排除条件要小心。序列化对比里编不出 hold-constant 语义的序列化器没资格。表示对比里表达不了要求区分的家族可能正是测的东西, drop 它藏了发现。编不出 control 和表达不了任务要求区分不同。
成本、精确与 null 语义
字节、字符、分词器有处模型分词计数、正确归因处 provider 报告输入用量都测;计数按[第 2 章](/zh-cn/books/context/02-chapter/)的词汇标观测派生估计 joined。二十对象六重复键的 JSON 数组键名渲染 up to 一百二十次,表格六 header 渲染一次。那是结构对比,不是 token 省:字段值、转义、缺失值约定、行标识、解析要求也贡献。测得输入 token 数低不一定轨迹成本低,重试澄清转换涨就。CSV 有分隔 header 约定,本身不表达逐格类型或空字段的 domain 语义。
表示 token 成本 ≠ 轨迹成本
错误重试澄清转换 work 涨就。
精确 fixture 渲染 judge 前先声明语义。fixture 区分显式 null(已知不可用)、缺席字段(没给)、空字符串、数值零。含义归 fixture 契约,不归标点,每序列化保留它们要有 unambiguous 的办法。前导零标识符 "01947" 只有 domain 当标识符才要求字节精确保留;当数字,丢零的数值转换不一定错。类型检查因此要句法 domain 两层标准:
句法类型 ≠ domain 类型
来源冲突同样。表示带显式来源字段,字段在场不是来源验证。它保留分歧也行,归一化静默塌冲突不行。指代 ambiguity 两 case 分开:确定性 fixture 从典范 state 生成显式 role,生产从散文转换要解释带风险。
读与更新
读准不等于更新安全。更新任务里模型拿到冻结 state 表示、观察、显式 transition 规则,产出下 state。评估器检查意图变化、须不变的字段全、标识符关系、合法状态 transition、输出 valid、不支持的添加。migration verified 标记要验证时间、验证者、block 原因清掉,那些依赖 fixture 指定;不然模型对没陈述的规则没法 judge。valid 局部 edit 不一定 valid state transition,valid transition 不一定后面 edit 还保留。
重复 edit(一三五)测要求 state 留存否,看不支持的添加、过时字段、丢失的关系来源、schema valid、成本增长。目标不是 round trip 后字符串相同。这是表示编辑不是压缩,[第 11 章](/zh-cn/books/context/11-chapter/)拥有。
机器互操作自己记账。可解析不是理解,schema valid 不是任务成功,任务成功不是集成价值。应用集成选 JSON,哪怕推理打平。
归一化是变换
归一化是异构来源上的一族操作,天生不是语义改写。它只改编码、保留现存语义结构也可能,把来源概念映进公共 schema 也可能,两样都做也可能。语义映射 case 经省略区分、新推断、错误等价改变含义;纯句法转换也挂,但它不自动是解释。这个区分重要,因为实验须把观测的损失归因到引入它的操作。选项不是二选一:
- **来源原生:**保留原表示。
- **典范语义表示:**每来源映进共享 schema。
- **典范序列化:**语义结构保留,统一编码。
- **混合:**选定字段归一化,来源原生证据保留。
归一化制造 false 一致。来源 A 说 status: blocked,来源 B 说 “waiting on tests”,mapper 两写 BLOCKED,可能擦掉区分。它也制造 false 冲突,done、complete、resolved 一意思时:
归一化相等  ≠  来源等价
来源不同  ≠  语义冲突
归一化还可能在模型见任务前解释。散文读"Service A appears to depend on B",归一化器写 depends_on(A, B),改善不是纯表示 effect,转换里的表示和语义推断分开。无 lineage(来源 identity、原表示、归一化器 identity recipe、输出表示、unknown 映射)的归一化数据弱化可审计。那是待陈述的要求,这里不设计 schema。
混合与一致性
一 plausible 生产结构是混合:类型化 state 旁短理由旁重复记录的表旁关系三元组旁引用的 raw 证据。混合是几种表示家族共存,因为它们 serve 声明的操作,说不出哪部分 serve 哪个操作的混合是堆。它是假设不是赢家。
混合制造自己的风险。类型化 state、散文理由、表格、三元组都断言重叠属性,经重复断言、版本 skew、不一致更新、drift 分歧:
表示多样 ≠ 免费冗余
两准入表示声称编码一属性,分歧须保持可见,不静默 reconcile。哪个管是[第 19 章](/zh-cn/books/context/19-chapter/)的问题。
生态门
真实轨迹的空语料不支持机器。建表示优化器典范归一化器前,真实轨迹测量当前准入的表示家族、来源原生已结构化 share、重复记录关系重候选 prevalence、精确字段 null vs unknown 义务、转换频率转换字段损失、一对象的重复形式、混合包、解析失败、schema mismatch、下游任务要跨源一致否、表示占 token share:
表示能重要 ≠ 表示选择是 prevalent 问题
提议的实验
这里什么都没跑。每任务家族单独报告,没有一分数平均。
**实验 A:语义组织。**冻结 fixture state、保留义务、模型任务,显式不同语义结构怎么影响操作 specific 行为与总资源?条件按 fixture 家族选:state 查找叙事对 label 记录;重复记录对比叙事对表格;关系遍历叙事对类型化三元组;解释散文对结构化决定理由字段,混合只在成分目的定义时加。每条件模型评估前审计义务留存。表示表达不了要求区分,失败报告成表示局限,不和受控义务等价对比 pool。oracle 是 hindsight 对比,暴露任务相关区分;不保证行为上界,呈现还 impair 使用。任务 fixture、渲染、随机跑分开计数。精度、不支持的断言、精确字段关系使用、编辑失败、现行 token、管理成本按操作报告;不同操作不平均成一 headline 数。
**实验 B:序列化。**语义 schema 冻结义务 hold constant,换具体编码:label 记录当键值文本 JSON XML,表格数据当 Markdown 表格 CSV。round-trip 解析验证 schema 层保留,不验证行为等价。字段行关系顺序尽量冻结,连同任务指令、渲染外分隔、例子、答案格式、framing。等价编码 token 长度能不同,decisive 事实位置移动,报告总输入 token、绝对归一化位置、离问题的距离。独立匹配不了,别 claim 纯格式 effect:认成完整渲染编码的 effect。单独边界 cue ablation 变 label 包装,不和主对比搞混。
**实验 C:归一化,只挣到才跑。**前面实验真实 workload 观察留 consequential 的异构来源转换问题才跑。对比来源原生输入、句法典范化(可行处)、确定性语义映射、模型生成语义映射、保留可恢复来源证据的混合、oracle 参照。下游用前审计每转换的省略 mutation 不支持添加状态来源关系类型 ambiguity 处理。再冻结输出单独评估模型。转换成功独立下游任务成功报告;转换改变来源含义,别 credit blame 下游表示 alone。实验 A B 没留下有意义的转换问题,C deferred。
**什么改变本书。**普通 label 键值文本打平精巧序列化,格式优化器去掉。模型差主导格式 effect,或省的相对别的上下文成本 negligible,或运行时操作拿掉大半模型侧结构化 work,同样去掉。典范归一化转换错误主导、来源原生赢、典范形式擦区分、一致没测得 benefit,或保留来源的混合更安全恢复需要信息,拒绝。混合复杂度核算表示成本、重复 state、一致性义务、管理开销后无实质操作 specific benefit,拒绝(维度分开报告,不合成一标量)。null 结果每 case 有用。
编译器渲染什么
[第 23 章](/zh-cn/books/context/23-chapter/)的编译器收到已产出验证过的候选表示。它在合格形式里选择组装,不发明缺失的紧凑表示,不重映候选的语义结构。它自己的 wrapper 还改变模型可见呈现:header label 分隔、条目顺序、结尾文本贡献 token,影响理解。编译器记录的组装不一定是 provider 的终渲染,[第 2 章](/zh-cn/books/context/02-chapter/)确立过,包的声明成本 identity 不保证渲染请求的 identity。渲染契约因此要自己的版本轨迹:
无语义变换  ≠  无表示 effect
确定性渲染  ≠  中性渲染
固定分隔影响理解,确定性给复现性不给中性。渲染文本是自己的对象,有自己的成本,和它渲染的包不同,第 23 章注渲染成本和条目成本声明和不同。包 identity 不是渲染表示 identity,跟踪重要([第 25 章](/zh-cn/books/context/25-chapter/))。
交接
表示保留来源 identity、来源、状态、冲突、置信度 metadata,义务要求处精确来源措辞。它定不了哪个来源管:
保留分歧 ≠ 解决分歧
几 well-formed 来源共享包,形式能做的做完了。剩下是分歧,第 19 章问谁 judge。
参考
- Sui, Y., Zhou, M., Zhou, M., Han, S., Zhang, D. “Table Meets LLM: Can Large Language Models Understand Structured Table Data? A Benchmark and Empirical Study.” WSDM 2024. https://arxiv.org/abs/2305.13062
- Li, L., Tian, J., Chen, H., et al. “LongTableBench: Benchmarking Long-Context Table Reasoning across Real-World Formats and Domains.” Findings of EMNLP 2025. https://aclanthology.org/2025.findings-emnlp.638/
- Lepagnol, P., Ghannay, S., Gerald, T., Servan, C., Rosset, S. “Format Matters: A Critical Evaluation of Output Formats for Prompting LLMs in SLU and NER.” LREC 2026. Output-format evidence only. https://lrec.elra.info/lrec2026-main-593
- Anthropic. “Prompting best practices.” Vendor documentation, verified September 2026. https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices
- OpenAI. “Structured model outputs.” Vendor documentation, verified September 2026. https://developers.openai.com/api/docs/guides/structured-outputs
- Model Context Protocol. “Tools.” Draft specification, verified September 2026. https://modelcontextprotocol.io/specification/draft/server/tools