测量仪器
改善之前先观察运行时为模型组装的上下文:观察器坐在哪、看不见什么,token 怎么计数,仪器为什么先 qualification 才能信任。
想象开发者在调一个又慢又贵的编程智能体。可见 transcript 显示八条用户消息、八条助手回复,看起来不大。然后他在 harness 层打开请求日志,发现第八次模型调用带了几万 token:项目指令第八次重发、从没调过的工具的工具定义、几乎完全重叠的两次文件读取,以及含四次失败工具调用及其完整 stack trace 的历史。整个会话用户只敲了几百词。harness 组装了一部中篇小说。
故事里的数是编的,故事是说明,不是关于多久发生一次的发现。论证不需要它常见。只需要这个:可见对话和为模型调用组装的上下文差很多,所以上下文须观测,不能从 transcript 推断。从 transcript 推理的开发者,可能在推理模型从没收到的文档。第一工程义务因此不是剪枝、压缩、检索任何东西。是看。
想象的提示词
把系统发给模型的东西描述成最新用户消息加历史指令很容易。智能体一轮组装的上下文能多得多:
系统指令
开发者与产品指令
项目指令
工具定义与 schema
对话历史
早期历史的摘要
文件与摘录
检索文档
工具结果与观察
图像与其他媒体
工作状态(计划、任务清单、笔记)
当前用户输入
每项都是某段具体软件做具体决定放进去的:harness 前置项目文件、框架默认追加每个工具 schema、历史管理器 concat 而不选择、压缩步骤把六轮换成没人检查的一段。Provider 文档对一家 provider 确认了大致形状:OpenAI 把缓存单位描述为模型的 full rendered context,包括 provider 指令、开发者消息、工具定义、对话历史,并把文本生成请求描述为无状态,除非重供状态。transcript 是 harness 可能每轮重建的结构的可见部分。
关于某运行时组装了什么的断言,要组装边界的证据,或观察同一问题的另一台仪器的证据。“我们把风格指南放进上下文了"含糊到不知道放哪、以什么形式、哪些轮次、什么代价。“历史太长了"在历史和指令工具检索材料分开前不可测量。观察在本书每个后面的动词之前。缺失的捕获不让关于系统的每种断言都失效;它限制这台仪器能测的断言。
只看的观察器
本书用的仪器是挂在真实编程智能体上的只读观察器(observer)。它坐在智能体宿主为模型调用组装好上下文、正要交出去的点上,每调用写一条记录。
那个位置就是测量边界,后面的每个断言须点名它:
可用信息与会话状态
              ↓
        运行时组装
              ↓
   [ 观察点:宿主的模型-上下文 hook ]   ← 记录的东西
              ↓
        provider 翻译
              ↓
        provider 与模型
线以上,观察器看到组装产出的东西。线以下,它直接什么都看不见。所以这台仪器的结果说的是宿主模型-上下文 hook 处观测到的上下文,不说模型看到了。宿主交出去的东西和 provider 最终渲染的东西的区别是盲区节的主题,本书说边界处观测到而不说模型收到正为这个。
只读是 deliberate 的约束。测量时改请求的仪器建不了基线,基线是上下文工程最稀缺的资源。陈述的不变量是观察不得修改交付的上下文:观察器拷贝事件,测试 pin 原件事后结构不变。那是关于上下文的断言,不是关于过程的。写记录花磁盘和时间,测试不测那个开销。
每条记录带会话与智能体、请求与观测的 provider 模型、请求种类、系统材料、消息、工具定义、请求选项、宿主报告的模型 limit、捕获时间、序列号、计时。两细节值得记住。
消息不是字符串平表。每条有 role 和 parts 表,parts 种类不同:文本、推理、带参数的工具调用、工具结果。这个宿主捕获里,工具结果没有可靠链回产出它的调用。所以 body 能比出重复内容,但内容相等本身证不了两结果来自同一次调用、描述同一文件版本、有同样意义。
序列号重启后存活。记录写之前预留,所以崩溃留下可检出的 gap,永不发重号。state 损坏、记录库不能 vouch 会话,会话按规则标不完整。原则是观察器可以承认 gap,绝不能发明连续。gap 意思是观测不完整。它不说什么活动丢了。
观察器是还装着注入器的包的机制之一,第 25 章描述。两者默认都关。默认开的仪器改变普通行为,默认关的静默失败,所以第二种失败要自己的 defence。
看推翻了什么
第一版计划在真实捕获存在前写的。它规定记录字段含权威性、范围、缓存 span,以及一套合成会话测试。观察器终于在 throwaway 仓库对真实会话跑,几个假设挂了。
消息形状和每个合成 fixture 假设的不一样。每 fixture 形式都错,真实会话会被静默误读,重复工具输出永远对不上。fixture 按真实形状重建,任何别形状的记录现在按不完整拒绝,不当理解了分析。
工具调用参数原来是捕获的。它们揭示智能体请求了哪些编辑、测试命令、重复调用,不用从周围散文推断那些请求。参数本身证明不了文件改了或测试跑完了;那些结果要对应的工具结果或独立 state 证据。
读模型 limit 的调用不存在,静默失败,所以每个 limit 都记成 unknown。换成宿主的模型 registry,没配 limit 的模型现在记为无 limit,不是零。
provider 报告的用量、成本、延迟、缓存读数原来不是 invisible:宿主自己的库里有。事后只读读。当前 join 只在助手消息数等于捕获请求数时准入会话,但数对上是必要一致性检查,不是每用量行属于配对请求的证明。这类值标 joined,不是上下文边界观测到,逐请求结论以 join 正确为条件。更强的 join 用稳定请求标识或独立检查的顺序。
记录根本不带权威性或范围。观察器看得见条目坐哪、说什么。看不见谁放的、它声称管什么,因为宿主不说。第 3、19、21 章依赖的那些字段,捕获给不了。须从后面建候选的东西来。
一个问题 open 着并保持 open。作者的日常配置加载别的插件,可能改变上下文,没确立观察器看到的是它们动作之前还是之后。校准会话因此不是 shipped harness 的 plain 基线,后面的会话记录这类插件活跃否。
教训 generalize:仪器是关于它测的系统的假设。不接触系统写出的 specification 会在没人想到的地方错,找出来的办法是早在小东西上跑一次,spec 被推翻的每处都记下来。仪器的输出当证据用之前,须对现实 qualification。
token 怎么计数
token 数不是请求的不随上下文的属性。它依赖表示、分词器或计数规则、观察点。本书三种计数重要。
数能声明(declared):候选的 builder 在组装前说它多少 token,对它声明的表示。能按规则估计(estimated),比如词数乘常数或字节除常数,对观察器捕获的文本。或调用后由 provider 报告(reported),对 provider 渲染的请求。前两种能提前做预算。第三种只能事后 reconcile。
这些不是同一个数,这里没确立它们一致。观察器的校准里,一会话一模型,词估计比同一请求的 provider 报告低约三分之一,字节除四近得多。那是那次会话上仪器的校准证据,大多英文文本与结构化数据。它不说两规则别处行为如何,也不把字节除四封为推荐估计。它说词估计没弄清它是哪个数之前,不该当预算根据。
两后果带到后面。记录的每个数说清它是三种里哪个,编译器的估计、宿主的计数、provider 的 input_tokens 永不 assumed 相等。编译器([第 23 章](/zh-cn/books/context/23-chapter/)说包 fit 预算,意思是候选声明的单位,和 provider 分词器的命题种类不同。分词器还跨模型变,跨模型比 token 数是近似的。
测量从哪来
计数是一条 general 规则的个案:每次测量带来源。仪器用小固定词汇。
| 状态 | 含义 |
|---|---|
| 观测(Observed) | 捕获记录直接读到 |
| 派生(Derived) | 观测材料确定性算出 |
| 连接(Joined) | 宿主自己的记录事后读到并配到会话;边界没看到 |
| 代理(Proxy) | 想要的东西的 stand-in,用到哪里标到哪里 |
| 声明(Declared) | 人或 builder 给的,从文本推断 |
| 没观测(Unobserved) | 捕获看不见 |
没观测不得静默转成零或缺席断言。那是后面一切的不变量:没观测不是缺席的证据。某会话没观测的量保持标没观测;要求观测值的计算排除它;报告说排除了几个会话。share 只在分子分母被兼容测量支撑时报告。真观测零保留为零。
干预前先基线
仪器定义了,本章能说测一次会话什么意思。基线是在任何干预前对捕获记录算的一组数,本书要八个。大多派生不存储,定义 deliberate 窄。
- 每调用渲染输入总量,会话级。字节在边界观测到;token 数是估计或 joined,说清哪个。
- **按类别与来源的 token。**指令 vs 历史 vs 工具 vs 文件是最小有用切分。类别指派从记录的类型 role 字段够用处派生;宿主不标识来源时更细的来源归因没有。类别里的 token 量还是标什么是什么(估计、声明、joined),不是直接观测的 token 数。
- **重复材料。**两窄意思:前面请求 verbatim 重发的 part,一请求里同一工具输出 body 出现多次。都是字节层派生,意思重复字节不重复的都检不出。
- **随轮次增长。**总量与每类别对轮次。
- **稳定前缀长。**和上请求相同的前导 span。这是 proxy:assumed 渲染顺序,provider 实际顺序没观测。
- **工具定义开销。**捕获请求里的名字、描述、schema,包括本节没调过的工具的定义。在场是观测到的;边界 token 代价是估计,除非有恰当分词器或计数。在场不证明 provider verbatim 渲染它们。厂商工程指南同样把工具描述与响应数当上下文成本设计。
- **工具输出增长。**工具结果的 token 及其在包里的 share 随时间。
- **文件与检索贡献。**项目文件、摘录、检索文档的 token,和历史分开,“模型懂代码库"才能对照展示的东西查。记录说清材料从哪才分得开。
本书后面的每次干预(去重、剪枝、压缩、外化)须移动至少一个数,再用受控对比证明行为活下来或变好。报省了而不给这些基线前后对比的章节,什么都没断言。
一次 work 的捕获
这里是调试会话第五轮,捕获的样子。类别和 token 数是为说明编的,不是测量;真表带测得的数,标哪种计数。
项目指令(稳定,1–5 轮)            1,900
工具定义(稳定,14 个工具)          6,200
对话历史(1–4 轮,增长)             9,800
以前的摘要(第 4 轮写)                900
重读源文件(2 个文件,80% 重叠)      7,100
工具结果(测试输出、搜索命中)        4,900
当前用户消息                            120
环境状态                                480
三件事没干预就可见。这个编的表里,用户消息占示意总数的半个百分点都不到。两大类是历史和文件,例子 assumed 文件读取重叠多、工具定义五轮 verbatim 重发。真观察器要底层内容对比支撑后两观察;类别 total 表 alone 证不了。例子展示分类捕获怎么让假设可测。它不说这些模式在真实会话里多 frequent。
稳定与动态
派生属性里稳定性值得强调,因为它连接观察与经济,三样不同的东西须分开。
第一是观测属性:span 跨捕获请求字节相同,比如没人编辑的项目文件。动态项再生、追加或替换:新工具结果、新检索、最新用户消息、重渲染时间戳。
第二是 provider 机制。OpenAI 的文档说缓存复用要求整个渲染前缀匹配,摘要、压缩、截断能改前缀、重置复用。这个机制下稳定前导 span 能复用,前部易变材料能阻止复用。
第三是经济后果:那个排布真降成本或延迟否。前两不确立它。provider 报告的缓存指标事后 joined,给 provider 关于什么拿到缓存处理的说法,不给为什么。那是 provider 的报告,不是观察器看到的,两记录 alone 都不是完整端到端观测。
稳定性还要和有用性分开。完全稳定的条目能无用或有害,易变的能 essential。稳定材料还是每轮的背景,很少重读,所以过时的项目规则能持续 exert 影响,这是检查它的理由。
重复是稳定性的 companion,不重复的增长(新观察)和不增长的重复(同样 preamble 重发)要不同回应。仪器分开它们。
测量不是改善
测量上下文 ≠ 改善上下文
本书要测的每技术现阶段都是没检查的 proposal。证明历史能摘要不证明该摘要。数出重复 token 不是删掉它们。删掉它们还不是改善:更小的 total、更稳的前缀、缩小的类别是测量差,行为、成本、延迟改善否是独立结果,要自己的对比。第 1 章的规则适用:效用断言在陈述的对比条件下成立,只在那里。
有时浪费和修复都 obvious。仪器还是重要。obvious 的浪费常常 load-bearing:重复指令可能是模型遵守它们的唯一原因,删除须测试不能 assumed。逐条记录让测试可能。
增长的形状是有用的起点,当诊断 heuristic,不当 established 签名。稳步累积最简单,也能是无用的累积。加速增长,工具输出触发更多调用、输出触发更多,可能是 productive 调查也可能是 thrashing。阶跃变化可能指向大文件读取、粘贴或压缩,值得按类别点名,不吸收进平均。形状告诉我们看哪。去掉驱动它的类别行为活不活下来,基线回答不了。它告诉我们消融跑哪。
基线期待 show 什么
本书还没有真实会话语料回答那个。下面是预测,写成待冻结测量确认或推翻的假设,没有一条测过。
**本书假设。**真实多轮编程轨迹里,重复和稳定但没检查的材料占渲染 token 的大头,用户自己的话是小少数。
更具体:工具定义从第一轮就是大固定成本;历史和工具输出主导增长;项目指令 verbatim 重发而重发买不到东西;重叠文件读取 recurring,因为每次检索不查包里已有什么。真实包如果 lean、不重复、用户主导,后面几章失去动机,报告会直说。 surprise 不了我们的基线不是基线。
**本书假设。**渲染顺序前部少量易变材料占缓存前缀失效的大头,不成比例。
这是建在文档机制上的会话层预测,仍要测量。链条是文档化的前缀匹配,再预测,再未来测量时间戳、会话标识、重排块多久打破本来稳定的前缀。即便如此,观察器的稳定前缀是 assumed 顺序下的 proxy。
仪器在 throwaway 仓库对 deliberate 校准会话跑过,测工具。那个会话排除在评估两假设的语料外,对 prevalence 零证据。但它提供上面说的窄校准证据:仪器碰到真实宿主数据,两 token 估计规则和 provider 报告的一致度不同。评估真实工作模式的 genuine 会话语料是空的。本书在这里把 gap 说全:它有合成 case 上的结构、传输、行为证据,加有限真实会话仪器校准,还没有这些上下文问题在日常工作里多久发生的证据。本书叫最后这类证据生态。 第 26 章把它和本书收集的另三类并排放,第 27 章说每种有多少。
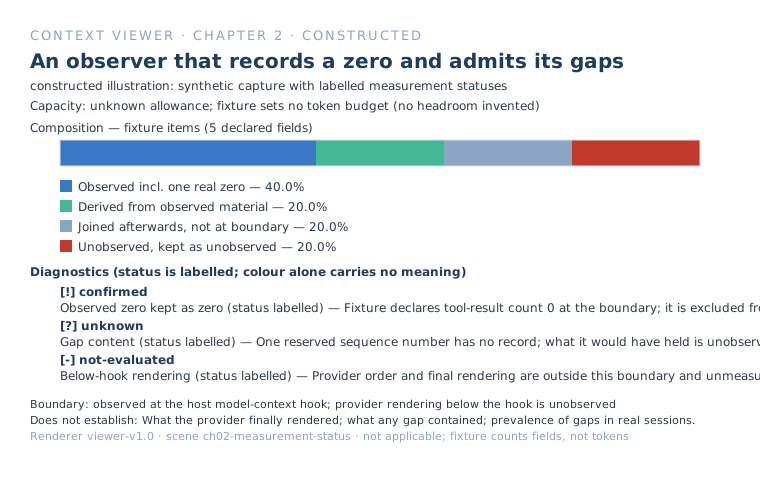
在 Context Viewer 里检查
本章的 viewer scene 把仪器 replay 成 label 的 fixture:五字段按测量状态、记录实际零的 live 观察器、什么都不记的 inactive 观察器、flag 的序列 gap。打开 scene 先读每值的状态再信。看什么:哪些数观测到、哪些派生或 joined、gap 承认自己不知道什么。这是状态词汇的构造说明;它没确立 provider 事实和 prevalence 断言。
仪器看不见什么
观察器在一处看到组装的上下文:宿主的模型-上下文 hook,运行时把它翻成 provider 期待的东西之前。那点之后一切对它 invisible。
模型-上下文观测 ≠ provider 线路捕获
盲区种类不同,区别重要。有些没观测的材料已知存在:服务器侧 state 比如 provider 存的对话条目或压缩表示不是发明的,加密或 redact 的 span 比如 opaquely replay 的推理条目记为在场但不可读。有些用别的仪器可恢复:provider 报告的用量事后 joined,说明能走多远。剩下 closed:provider 的缓存决策、观察点之后它加的东西、它渲染请求的顺序、推理材料到不到它、系统块在 harness 项目用户之间怎么切、父智能体和子智能体的关系。仓库 state 根本不在捕获里,观察器看到的是上下文修改插件动作之前还是之后,如上没确立。
仪器看不见的东西的集合须是每个用它的结果的一等部分。静默丢掉解析不了的东西的捕获不如没有,因为 total 对得上而 blindness invisible。捕获的上下文能含敏感材料,所以放本地从不提交,语料和生产日志同样处理。
观察边界不在的东西观察器数不了,那是关于边界的事实,不是关于条目的。
捕获还改变激励:团队盯 token 数后,类别能 cosmetic 缩小,材料能搬到没日志的通道,结果没改善。defence 是本书的 standing 规则:受控行为对比没有,优化不算数。仪器报告。实验决断。
仪器须 qualification
logger 记录。测量仪器有定义的边界、记录 schema、每数的陈述来源、已知盲区、会话算完整的规则、对现实的校准、跑过的证据。最常缺的是最后一个,本书后面长篇回来。没跑的观察器和什么都没看到的观察器看起来一模一样。
空记录库证明不了模型活动。观察器可能没开、挂在别的进程、写不进去,或根本没遇到 eligible 模型调用。所以观察器不因装了可信,不因版本对可信,不因文件对得上可信。可信的测量确立观察器开了、捕获了已知事件、事件属于分析的 run、记录完整 persist、序列规则没检出 gap。连续序列不是每模型调用都被拦截的证明:挂载前、hook 外、无预留序列号的调用都在保证外。完整因此意思是观察器定义的捕获与序列规则下完整,不是 provider 终提示词的完整视图,也不是真实工作的代表样本。
本章陈述要求。第 25 章讲跳过它的实验会怎样。
它制造的问题
组装的上下文可见并数过后,问题从系统发了什么变成每部分从哪来。厂商和产品团队写的指令、代码生成的工具 schema、harness 注入的项目文件、无显式动作累积的历史摘要:每样都有用户没敲的来源。它们在真实请求里占不占主导是经验问题,本章没测。下一章打开对象问。
如果检查真实请求,模型收到的东西里多少是用户从没显式敲的?
参考
- OpenAI. “Prompt caching.” Official documentation, verified September 2026. Full rendered context as cache unit; requirement that the entire rendered prefix match; compaction and truncation can reset reuse; cached tokens reported in usage. Provider-specific. https://developers.openai.com/api/docs/guides/prompt-caching
- OpenAI. “Conversation state.” Official documentation, verified September 2026. Text generation requests are independent and stateless unless state is supplied. Provider-specific. https://developers.openai.com/api/docs/guides/conversation-state
- Anthropic. “Writing effective tools for agents — with agents.” Published 11 September 2025. Vendor engineering guidance; tool responses consume context and should be designed for token efficiency. https://www.anthropic.com/engineering/writing-tools-for-agents
- Project Context OpenCode. Source repository, Apache-2.0 licence, first-party code by this book’s author. The read-only observer, its record format and its calibration notes. https://github.com/ernanhughes/project-context-opencode